#1 今天 14:17:41

32GB RAM 本地跑 DeepSeek V4.1 Flash 初體驗
前幾篇我們用 Strata 在雙 2080 Ti 22G 上跑 Qwen 系列的 MoE 模型。Strata v0.2.9 加入了 DeepSeek V4.1 Flash(5,440 億參數的 MoE),但官方的硬體表只列 RTX 30/40/50,預先編好的引擎也沒有 2080 Ti(Turing,sm_75)。
我們讀了原始碼,發現引擎其實有為 RTX 20 保留一條舊架構的運算路徑,只是官方沒編、沒測。這篇記錄我們自己編譯、下載約 240 GB 模型檔、實際跑起來的過程,以及量到的速度和瓶頸。
■ 先講結論
---
◆ 01 測試平台
| 項目 | 規格 |
|---|---|
| 主機板 | MSI X470 GAMING PLUS MAX |
| CPU | AMD Ryzen 5 3500X(6C/6T) |
| RAM | 32 GB DDR4-2400(4 × 8 GB,插槽已滿) |
| 顯卡 | RTX 2080 Ti 22G(改裝)× 2,NVLink 橋接 |
| PCIe 實際連結 | 3.0 x8 / x8 |
| 模型碟 | ADATA LEGEND 700 512 GB(PCIe 3.0、無 DRAM 快取) |
| 系統 | Ubuntu 26.04、驅動 595、CUDA 13.1、gcc 15 |
| 推論引擎 | Strata v0.2.9 的 DeepSeek 引擎 strata-dsv41(自行編譯 sm_75) |
| 模型 | DeepSeek V4.1 Flash 1017,ISTA-DASLab IQ1_M(1.75 bpw) |
◆ 02 官方沒列,但原始碼留了路
Strata v0.2.9 的 DeepSeek 引擎是獨立的程式(strata-dsv41,源自 project-maya,MIT 授權),官方預編套件只有 sm_86/sm_89/sm_120 三種機器碼。我們一開始也以為 2080 Ti 沒機會,讀了原始碼才發現:
所以只要把編譯目標改成 75 就行。官方的 Linux 編譯腳本可以直接用,只改 ARCH:
SRC=~/Strata B=~/Strata/build-dsv41 CUDA=/usr/local/cuda-13.1 \
GG=~/Strata/third_party/llama.cpp ARCH=75-real JOBS=5 \
nice -n 19 bash packaging/build_dsv41_cuda.sh---
◆ 03 選量化、下載 240 GB、打包
官方提供三組量化,都要再加共用的 Engram 查詢表(111 GB)和 DSpark 草稿模型(8 GB):
| 組合 | 模型 | 合計下載 | 官方建議 RAM |
|---|---|---|---|
| IQ1_M 1.75 bpw(本文) | 121 GB | 239 GB | 34 GB |
| IQ2_XXS 2.00 bpw | 138 GB | 257 GB | 40 GB |
| IQ2_XS 2.25 bpw | 155 GB | 274 GB | 44 GB |
---
◆ 04 冒煙測試與實際回答
官方的 smoke.py 會問「法國首都是哪裡」,並檢查回答的文字(要有 Paris、要是正常單字),不是只看程式有沒有正常結束,因為打包錯誤時會出現「跑得完但全是亂碼」的情況。
我們的結果:The capital of France is Paris.(含載入共 60 秒)
接著用中文實測。問題是「用繁體中文約三百字說明,為什麼 MoE 模型可以用比總參數量小很多的顯示卡記憶體來執行,分點說明並舉生活比喻」,回答節錄:
混合專家(MoE)模型能用遠小於總參數量的顯示卡記憶體來執行,主要有以下幾個原因:
1. 稀疏激活:MoE 模型雖然總參數量很大,但每次輸入只會激活少數專家……
(中略)
生活中的比喻:就像一家大型餐廳有上百位廚師,但客人點餐時只會叫其中兩三位廚師來做菜……
另外給它約 2,300 token 的 Strata 中文 README,請它用五點摘要,有抓到主要重點。這只是幾次人工檢查,不足以代表模型整體品質。
---
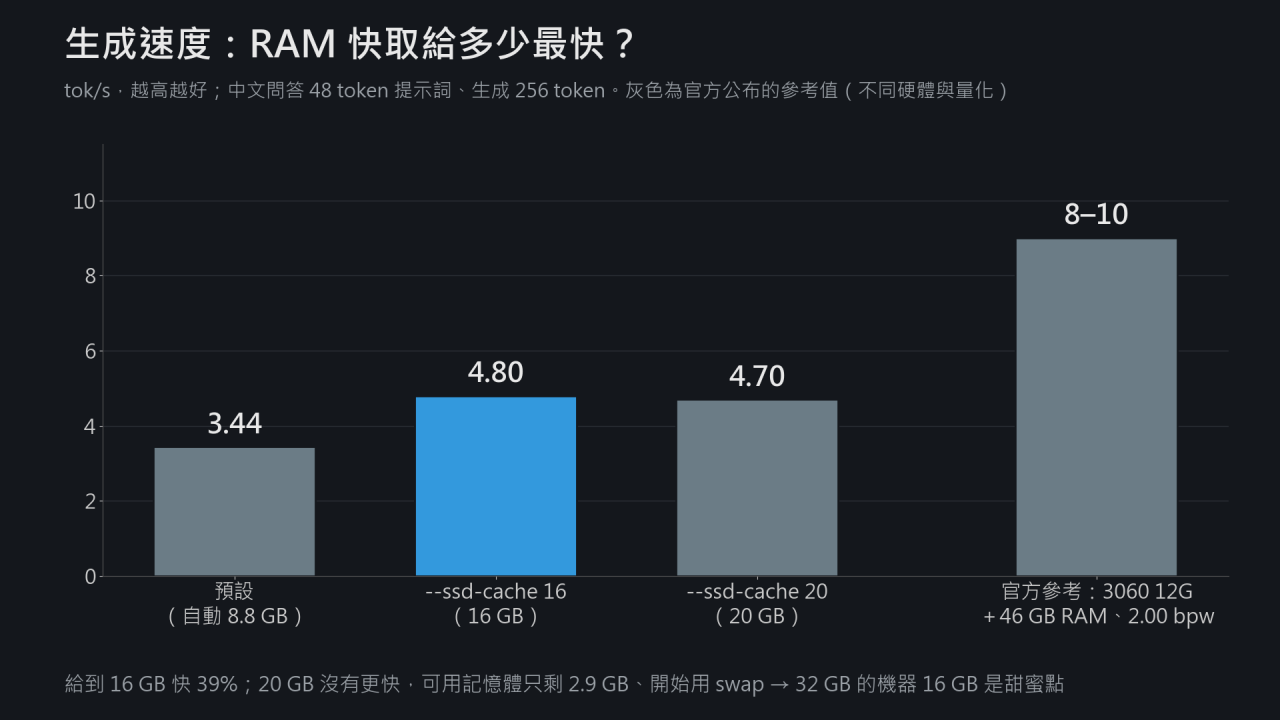
◆ 05 速度:RAM 快取給多少最快?
| 設定 | 讀提示詞 | 生成 | 每 token 讀硬碟 | RAM 快取命中 |
|---|---|---|---|---|
| 預設(引擎自動給 8.8 GB) | 2.5 tok/s | 3.44 tok/s | 249 MB | 68% |
| --ssd-cache 16 | 3.3 tok/s | 4.80 tok/s | 167 MB | 78% |
| --ssd-cache 20 | 3.4 tok/s | 4.70 tok/s | 167 MB | 80% |
| 長提示詞 2,323 token(16 GB) | 35 tok/s | 3.23 tok/s | 255 MB | 75% |
DSpark(推測解碼,類似 MTP):開了反而慢 12%
引擎預設(--dspark auto)在這台自動不開,記錄裡的理由是專家總量 115 GB 遠大於顯存 44 GB。我們用 --dspark on 強制開啟,同一次開機連續對照:
| 設定 | 生成 | 卡上的專家 | 每 token 讀硬碟 | 每輪產出 |
|---|---|---|---|---|
| 不開 | 4.19 tok/s | 4,113 個 | 173 MB | 1 token |
| --dspark on | 3.69 tok/s | 3,407 個 | 202 MB | 1.64 token |
| --dspark on --dspark-block 3 | 3.65 tok/s | 3,407 個 | 201 MB | 1.60 token |
注意:這組是剛開機、磁碟快取還是空的時候量的,所以「不開」只有 4.19,比上表的 4.80 低。比較時請看同一組內的差距,不要和上表混用。
---
◆ 06 時間花在哪裡?
我們的雙卡合計 44 GB 顯存,約為 3060 12 GB 的 3.7 倍,生成速度卻只有官方數據的一半左右。不過官方那組的 RAM、CPU、SSD、量化(2.00 bpw)和測試輸入都和我們不同,速度差不能直接說明原因。以下用我們自己的時間拆解來判斷瓶頸。
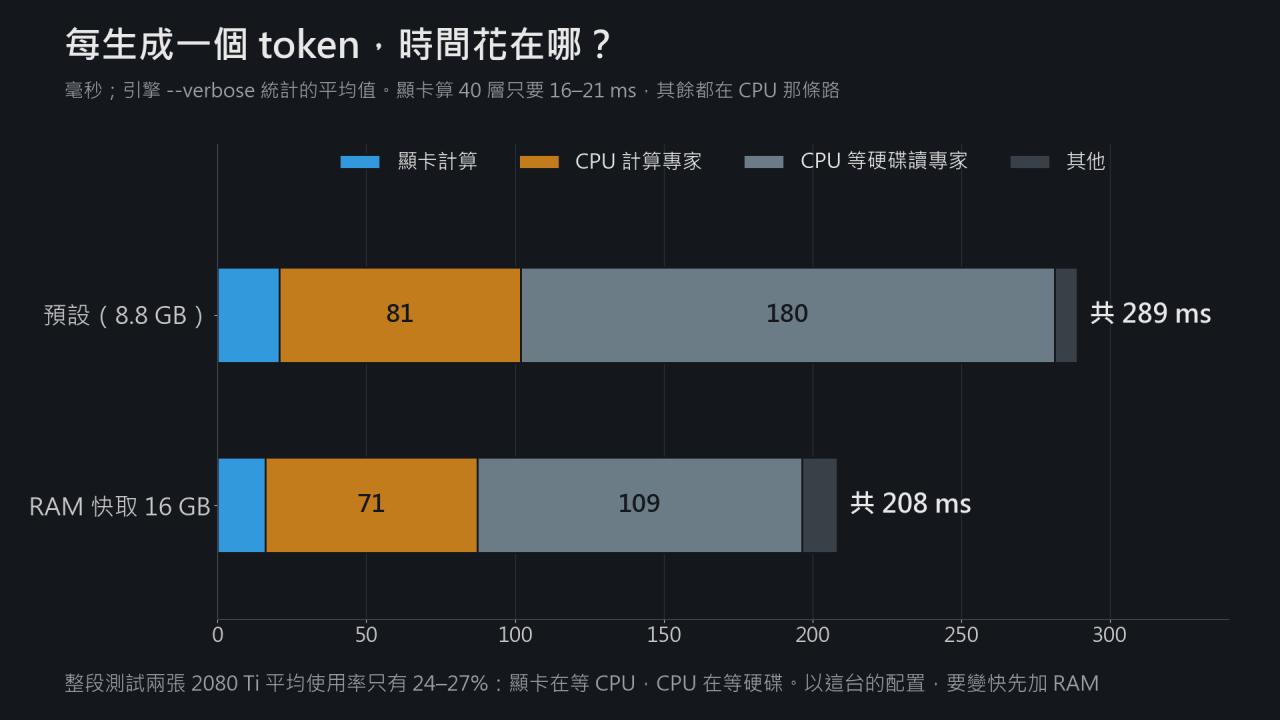
引擎的 --verbose 會列出每個 token 的時間花在哪裡:
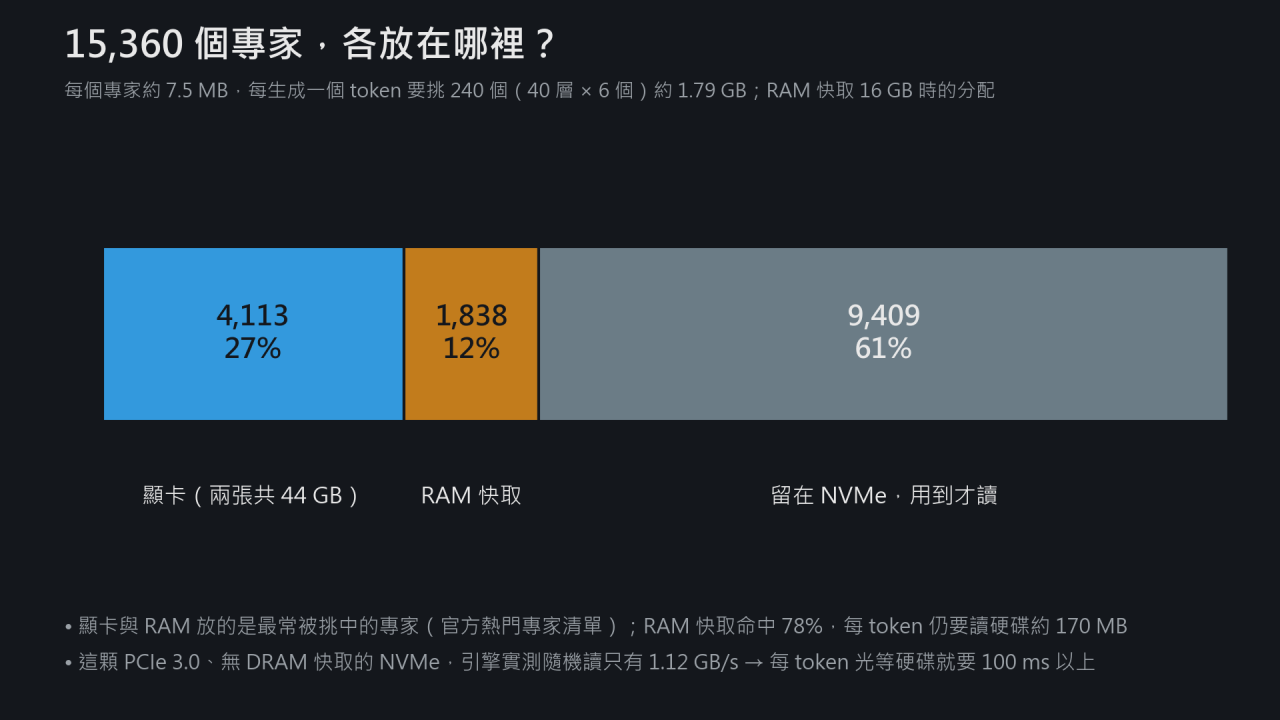
結論:在我們這台雙卡、32 GB RAM 的配置下,時間主要花在 CPU 路徑與 SSD 讀取,顯卡運算只佔一小部分。如果要升級這台,我們的優先順序是:
---
◆ 07 過程中踩到的雷
---
◆ 08 值不值得跑?
---
■ 參考連結
■ 同系列文章
(圖表與原始數據都是我們自行量測整理,歡迎討論或指正。)
線上
相關討論主題
| 主題 | 回覆 | 點閱 | 最後發表 |
|---|---|---|---|
|
Strata 實測: RTX 3060 12GB+32GB RAM 跑 125B 作者 Service
|
0 | 174 | 2026-10-30 16:33:23 作者 Service |
| 0 | 420 | 2026-10-22 11:56:31 作者 Service | |
| 0 | 1024 | 2026-10-10 13:07:12 作者 Service | |
|
|
16 | 58155 | 2019-07-19 23:49:33 作者 hemmis |
|
|
26 | 78603 | 2019-03-24 17:15:36 作者 fishkoka |


