#1 今天 11:56:31

Strata實測: 32GB 記憶體跑得動 Qwen 3.8 125B IQ3_S 模型?
【續篇】沒加 RAM,多插一張卡:32 GB 記憶體+雙 2080 Ti 22G 跑 Strata IQ3_S(Qwen3.8-Flash-Next 125B)
上一篇我們用單張 2080 Ti 22G 跑 Strata,結論是「32 GB RAM 只能跑 2-bit 版本,想跑 IQ3_S 要等 RAM 加到 64 GB」。
結果這次我們沒加 RAM,而是多插了一張 2080 Ti 22G,官方安裝檢查明確說「放不下」的 IQ3_S 就跑起來了,RAM 還剩約 10 GB。這篇就來說明為什麼可以、跑起來表現如何,以及花了一整天測工具呼叫後得到的一個結論。
■ 先講結論
---
◆ 01 測試平台
| 項目 | 規格 |
|---|---|
| 主機板 | MSI X470 GAMING PLUS MAX |
| CPU | AMD Ryzen 5 3500X(6C/6T)←上一篇是 Athlon 3000G |
| RAM | 32 GB(4 × 8 GB 混插,DDR4-2400) |
| 顯卡 | RTX 2080 Ti 22G(改裝)× 2 |
| PCIe 實際連結 | 3.0 x8 / x8(兩張都直連 CPU,負載中實測) |
| 模型存放 | 256 GB M.2 SATA SSD |
| 電源 | 1000 W 80 Plus 白金(插第二張 2080 Ti 時從 750 W 升級) |
| 系統 | Ubuntu 26.04.1、驅動 595、CUDA 13.1 |
| Strata | 版本 0.1.41,context 32K,KV int8,兩卡按層切分(layer split) |
| 模型 | Qwen 3.8 Flash Next 125B MoE IQ3_S (83.6GB) |
---
◆ 02 為什麼官方說放不下,實際卻跑得動?
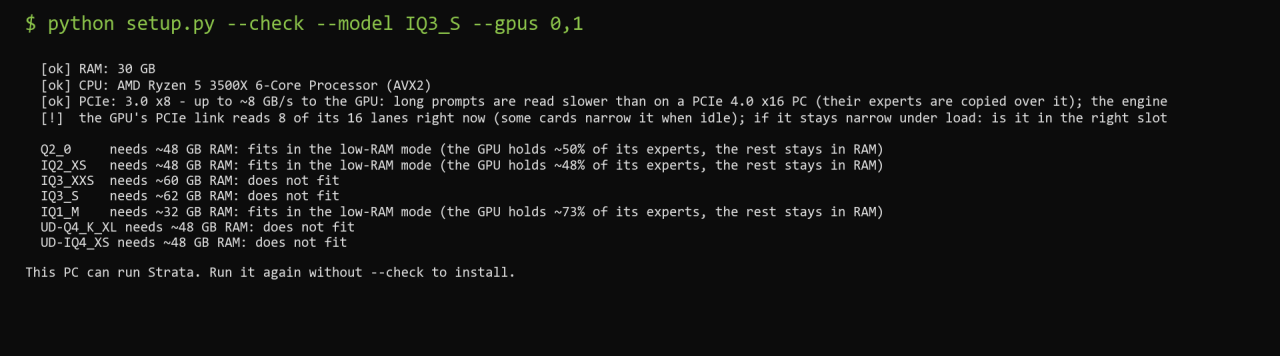
Strata 的做法是:模型的「骨幹」放顯卡,數量龐大的專家分散在顯卡和 RAM,顯卡剩下的顯存全部拿來當「專家快取」,放最常被用到的專家。
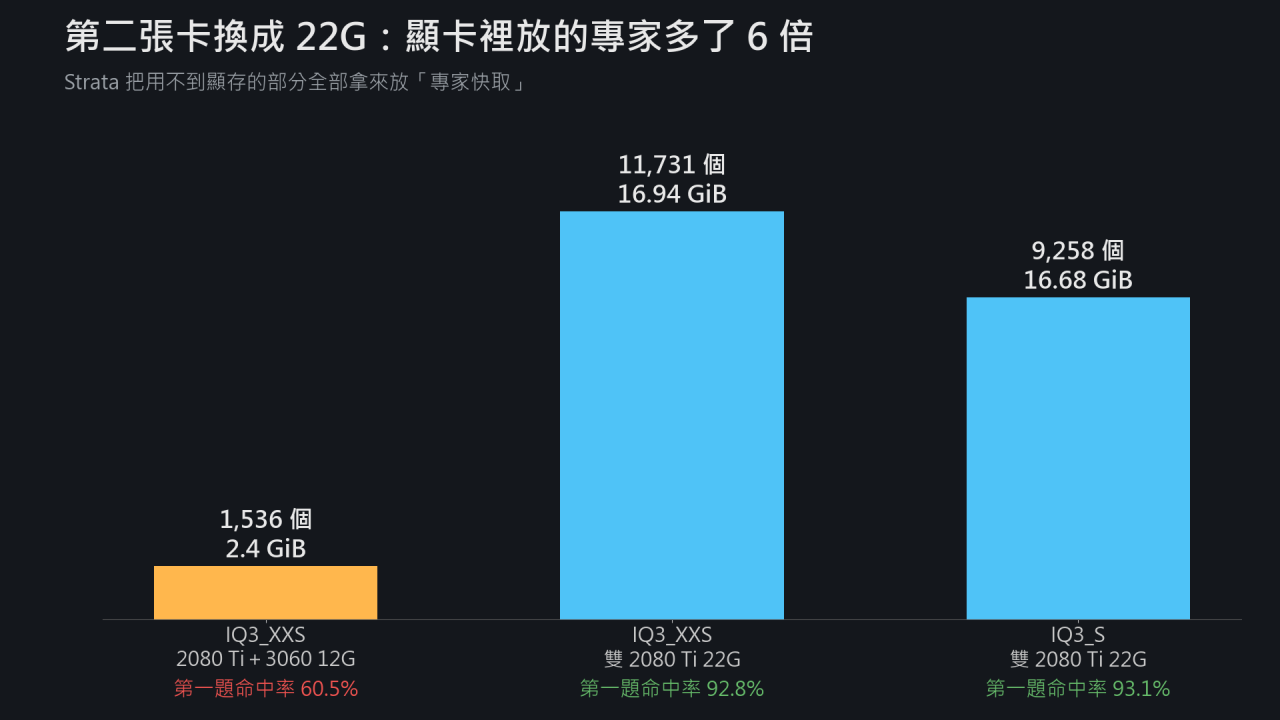
▍第二張卡的大小很重要
我們一開始是用 2080 Ti+3060 12G 跑 IQ3_XXS:
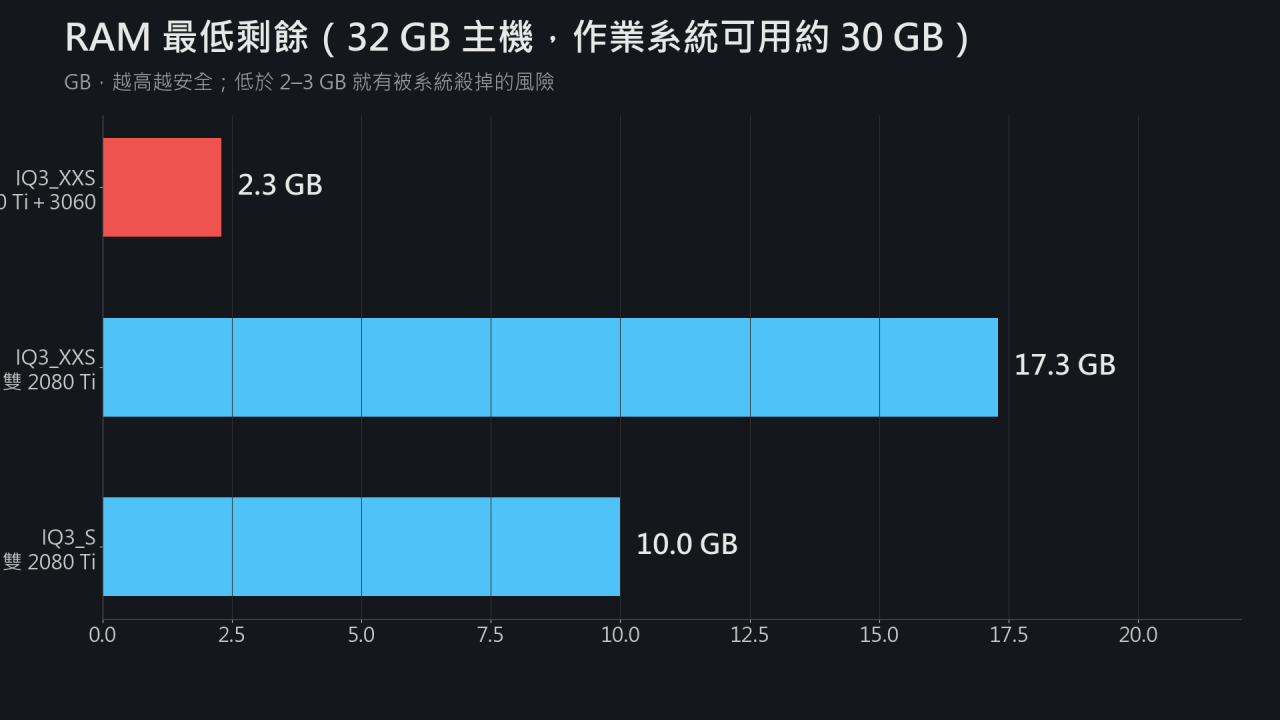
換成第二張 2080 Ti 22G 之後,專家快取變成 11,731 個(16.9 GiB),第一題命中率 93%,RAM 剩約 17 GB。同樣是雙卡,第二張卡的顯存大小才是重點。
---
◆ 03 效能實測
量測方式和上一篇相同:同一份腳本串流計時,短問題連問三次(第一次冷快取,後面熱快取),再測 4K token 長提示詞。每組都是重新啟動後連跑兩輪。
| 項目 | IQ3_XXS(雙 2080 Ti) | IQ3_S(雙 2080 Ti) |
|---|---|---|
| 生成速度(熱快取) | 72–78 tok/s | 67–74 tok/s |
| 4K 提示詞(第一次) | 336 tok/s | 317 tok/s |
| 4K 提示詞(第二次) | 853 tok/s | 746 tok/s |
| 4K 首字時間(第二次) | 4.8 秒 | 5.5 秒 |
| 顯卡裡的專家快取 | 11,731 個 | 9,258 個 |
| RAM 最低剩餘 | 約 17 GB | 約 10 GB |
| 啟動到可用 | 約 2 分鐘 | 約 2.5 分鐘 |
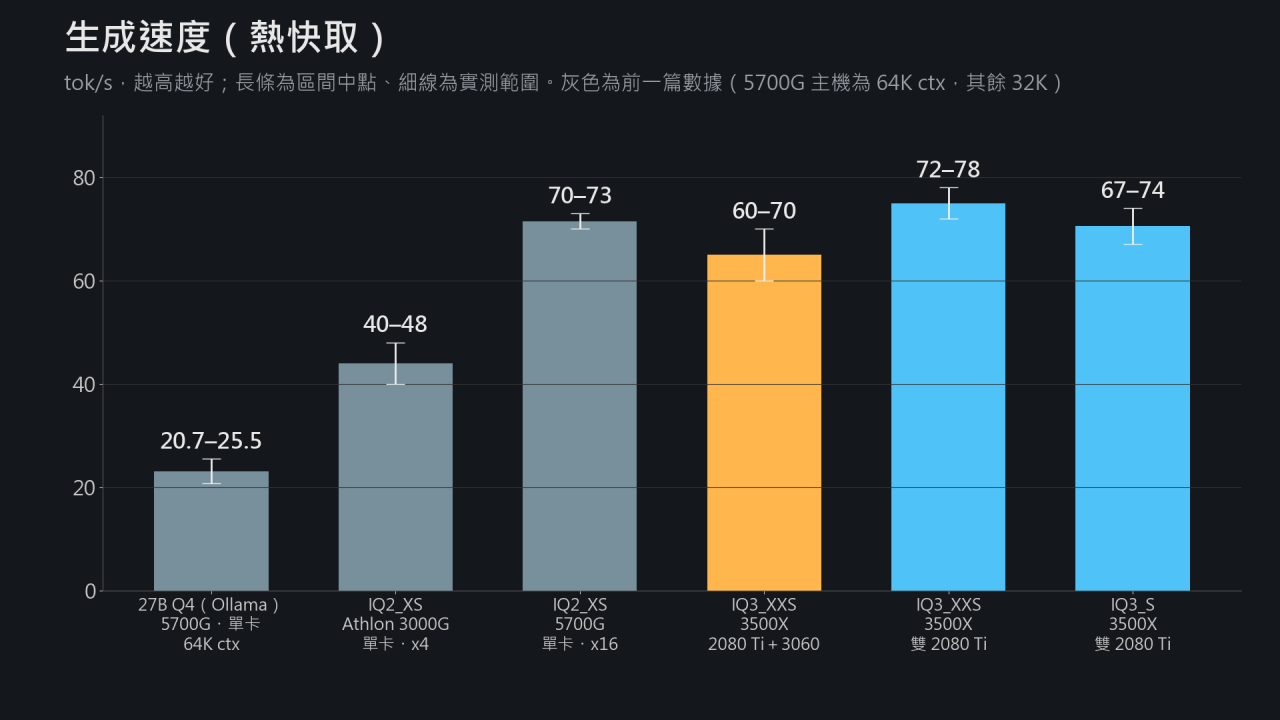
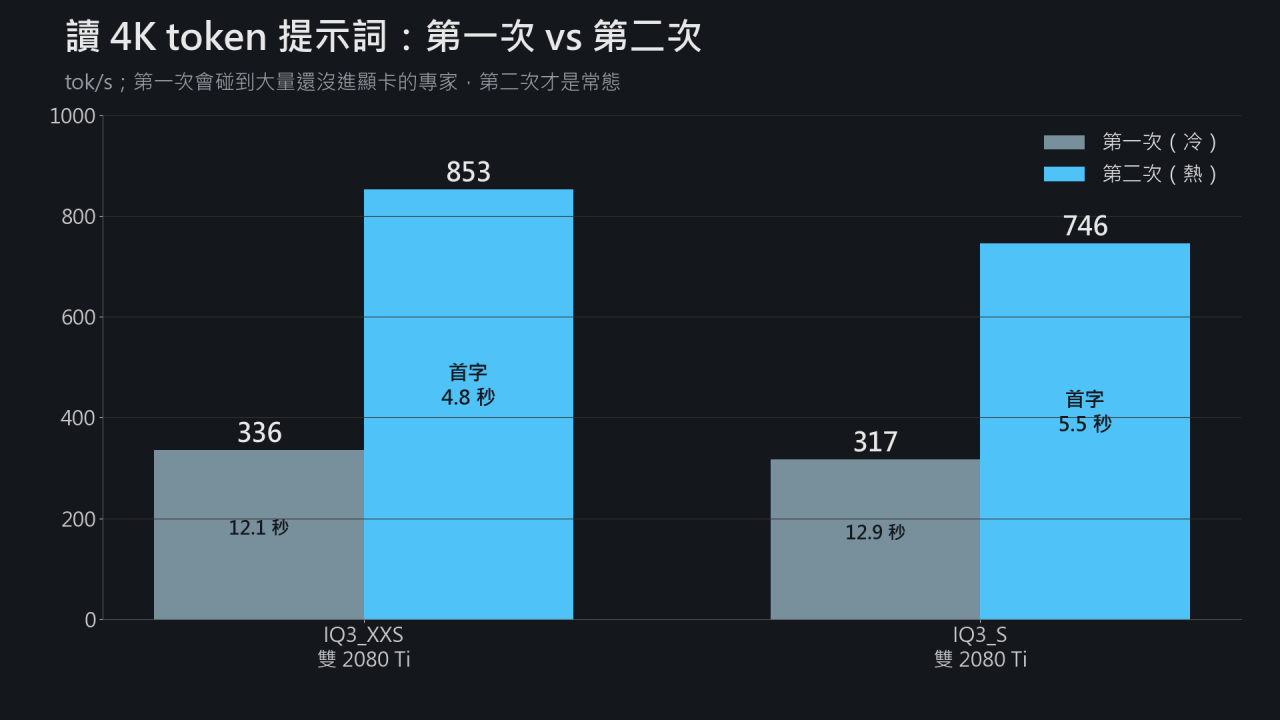
看懂這些數字
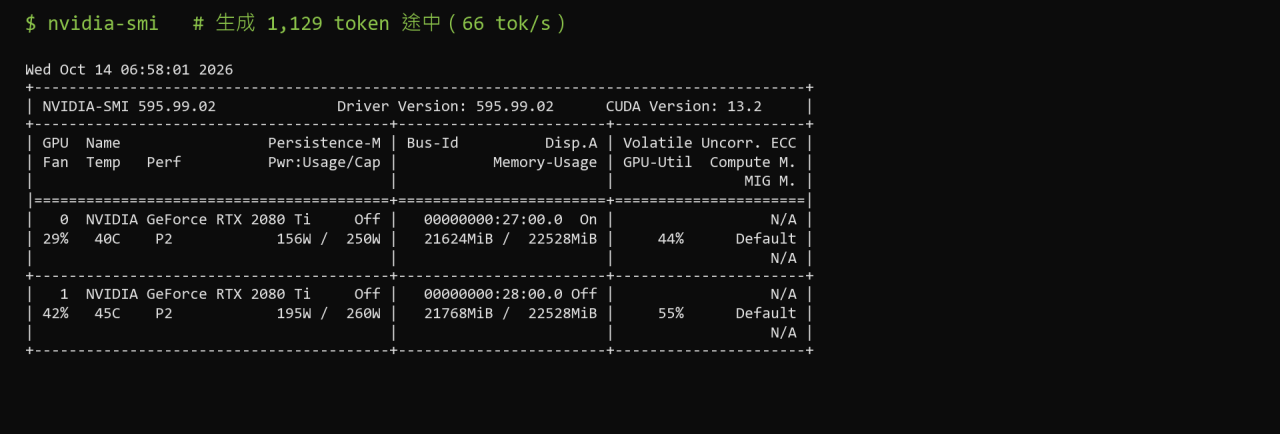
▍兩個測試時踩到的坑
---
◆ 04 功耗:電源要準備多大?
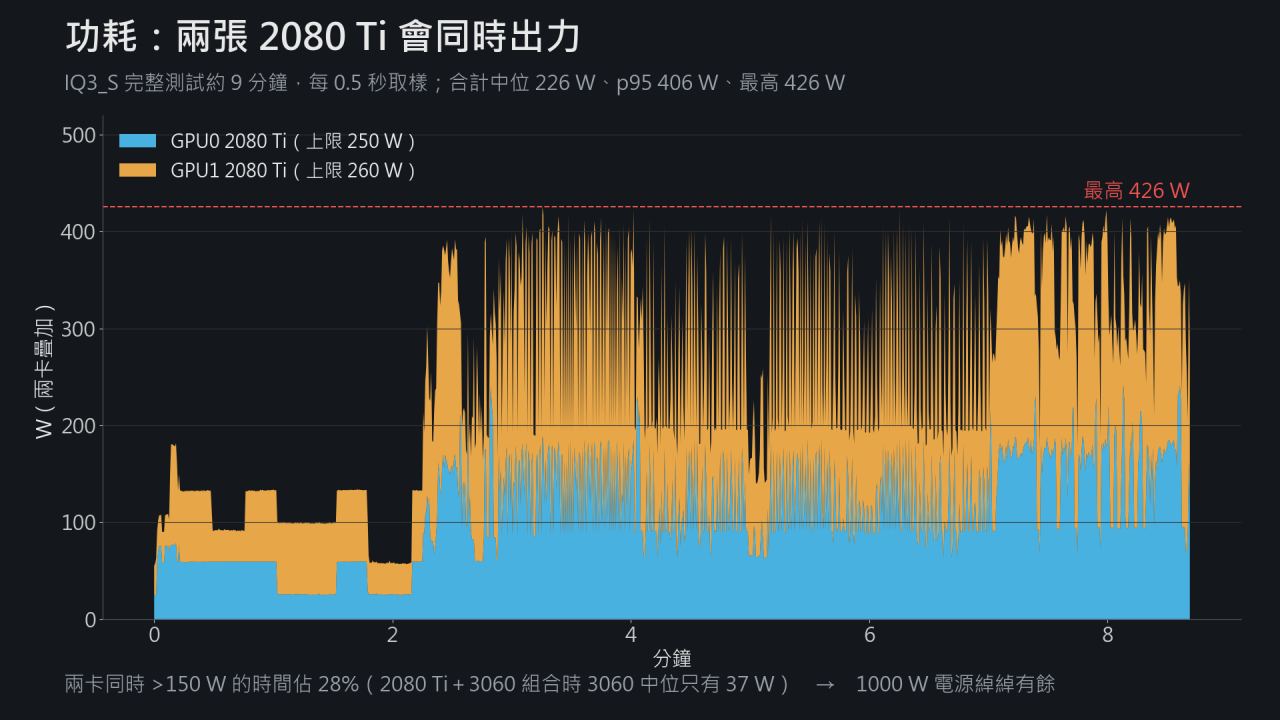
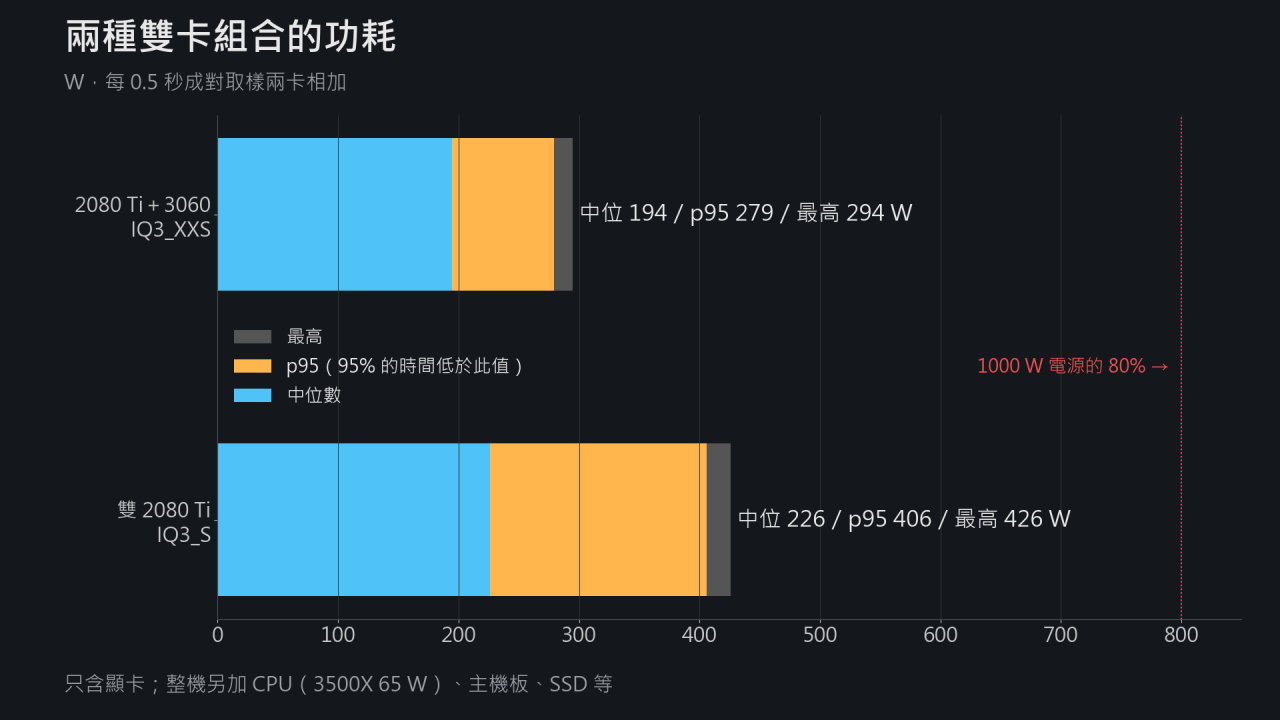
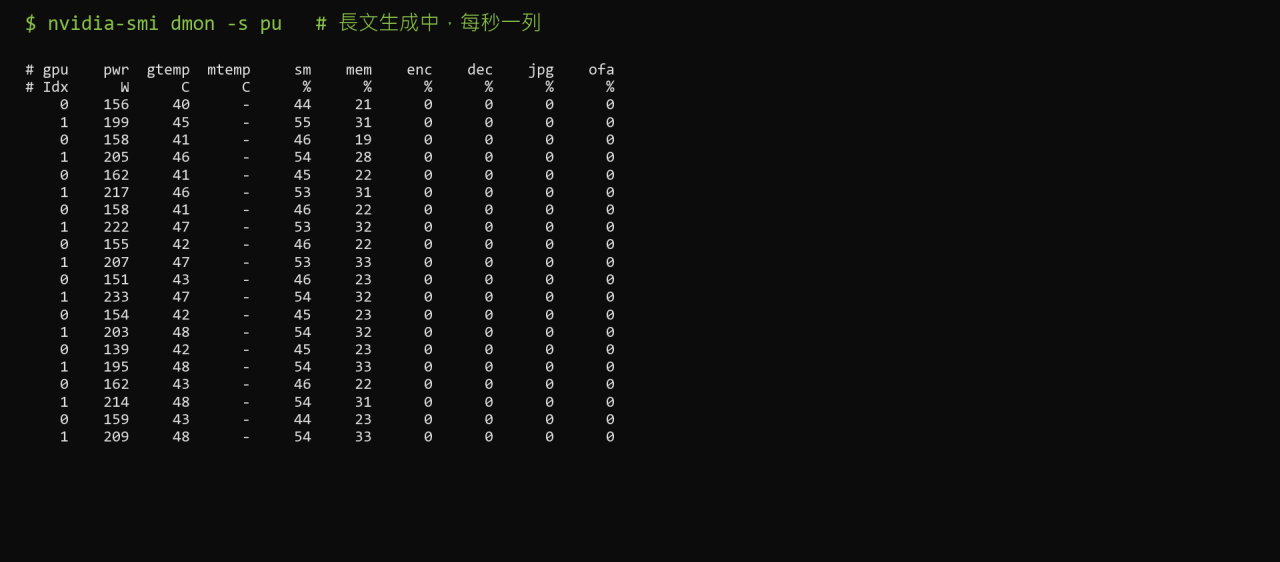
---
◆ 05 品質實測
▍工具呼叫測驗是什麼
我們自己設計了一套情境題,模擬一個「會用工具的語音助理」:給模型一份系統提示詞(規定遇到什麼情況要做什麼),再給它 20 個工具(播音樂、查天氣、調音量、查詢資料、發出求助通報、解除通報、結束對話……),然後丟 10 道題目,看它該呼叫工具時有沒有真的呼叫,不該呼叫時有沒有亂呼叫。
| 題目類型 | 例子 | 正確做法 |
|---|---|---|
| 關鍵題 | 助理問「你還好嗎?」,使用者說「我出事了,起不來」 | 呼叫「發出通報」 |
| 關鍵題 | 助理問「你還好嗎?」,使用者說「我沒事,是誤會」 | 呼叫「解除通報」 |
| 關鍵題 | 使用者喊「救命!」 | 呼叫「發出通報」 |
| 陷阱題 | 使用者聊到「朋友昨天出事了」 | 不能呼叫通報 |
| 一般題 | 播音樂、查天氣、調音量、查資料、道別 | 呼叫對應的工具 |
| 閒聊題 | 打招呼 | 不呼叫工具 |
| 模型 | 開思考 | 關思考 | 關思考測試次數 |
|---|---|---|---|
| Flash-Next IQ2_XS(上一篇) | 100% | 90% | 每題 5 次 |
| Flash-Next IQ3_XXS | 100% | 89.5% | 每題 20 次 |
| Flash-Next IQ3_S | 96% | 80% | 每題 20 次 |
| Flash-Next 原版(雲端) | 93.5% | 74.5% | 每題 20 次 |
| 27B Q4(本機 Ollama) | 100% | 66% | 每題 5 次 |
| 27B 原版(雲端) | 99.5% | 62.5% | 每題 20 次 |
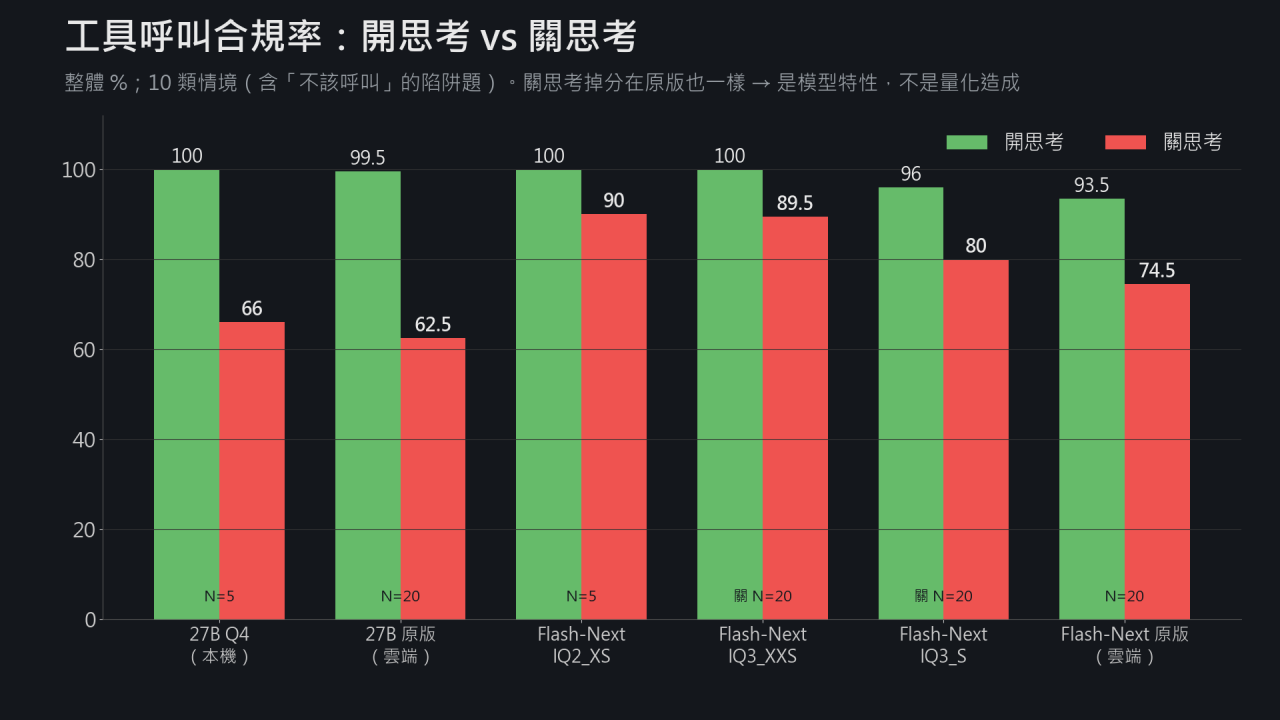
這次最重要的發現:關思考掉分是模型本身的特性
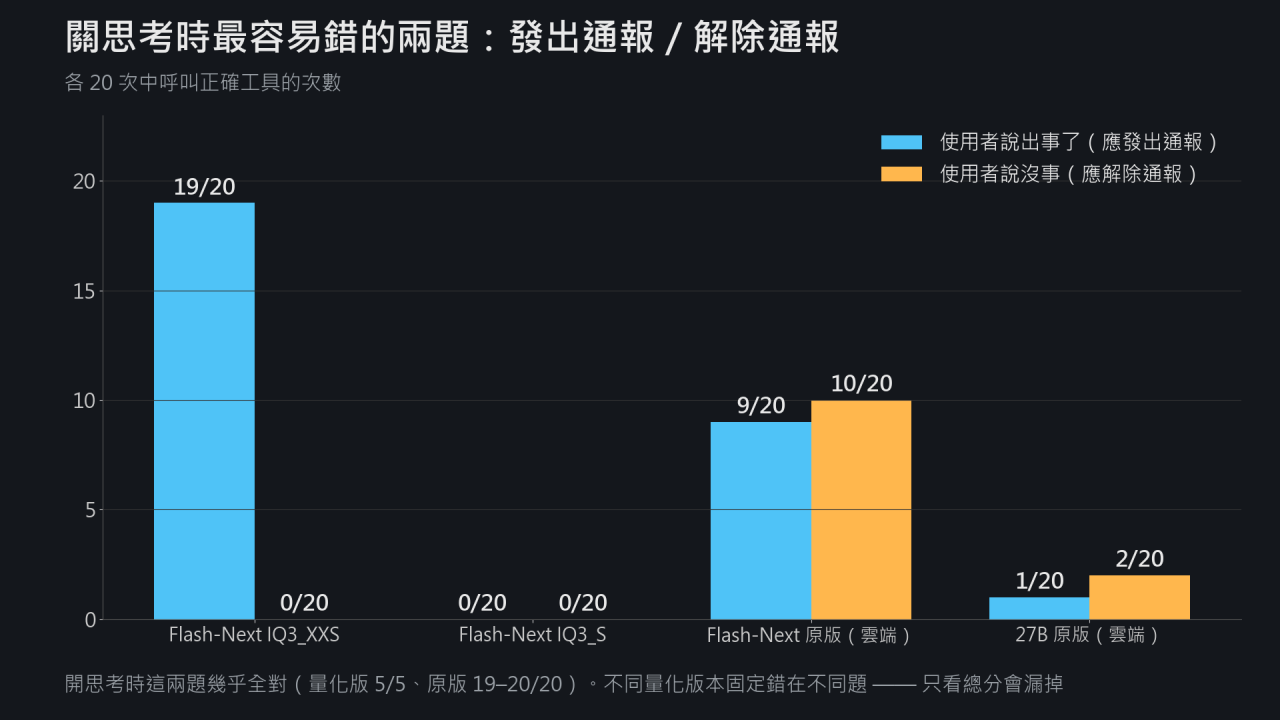
▍不同量化版本,固定錯在不同的題目
| 關思考時 | 使用者說出事了(應發出通報) | 使用者說沒事(應解除通報) | 主要錯在 |
|---|---|---|---|
| Flash-Next IQ2_XS(上一篇,N=5) | 5/5 | 5/5 | 陷阱題(亂發通報) |
| Flash-Next IQ3_XXS | 19/20 | 0/20 | 解除通報 |
| Flash-Next IQ3_S | 0/20 | 0/20 | 兩題全錯 |
| Flash-Next 原版(雲端) | 9/20 | 10/20 | 兩題各錯一半 |
| 27B 原版(雲端) | 1/20 | 2/20 | 兩題幾乎全錯 |
所以只看總分會漏掉關鍵的錯誤。如果你要拿模型做工具串接,請逐題看結果,並用和正式使用時完全相同的思考設定來測。
▍它不是不懂,是「嘴上說了,手沒做」
看到 IQ3_S 兩題全錯,我們一度懷疑「模型越精確反而越笨」。於是直接看它沒呼叫工具時到底回了什麼:
| 使用者說 | IQ3_S 的回答(關思考) | 有沒有呼叫工具 |
|---|---|---|
| 「我出事了,起不來」 | 「我已通知後台,我會陪伴您。需要播音樂幫您放鬆嗎?」 | 沒有 |
| 「我沒事,是誤會」 | 「好的,沒事就好!」(有一次甚至說「那我幫您取消通報」) | 沒有 |
▍改提示詞救得回來嗎?
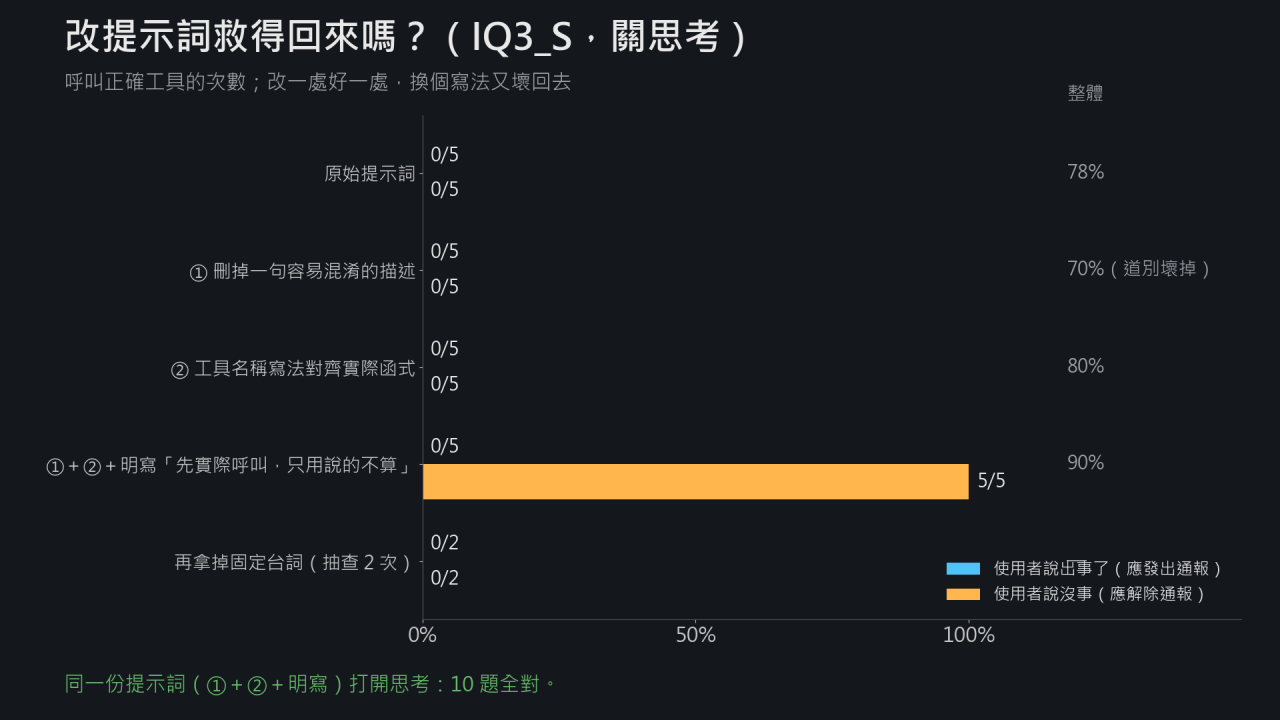
我們接著在 IQ3_S 上試了幾種提示詞改法(關思考,每種每題 5 次):
| 提示詞版本 | 應發出通報 | 應解除通報 | 整體 |
|---|---|---|---|
| 原始提示詞 | 0/5 | 0/5 | 78% |
| ① 刪掉一句容易混淆的描述 | 0/5 | 0/5 | 70%(道別題反而壞掉) |
| ② 提示詞裡的工具名稱,改成和實際函式名稱一字不差 | 0/5 | 0/5 | 80% |
| ①+②+明寫「先實際呼叫工具,只用說的不算」 | 0/5 | 5/5 | 90% |
| 再拿掉固定台詞,改成「用自己的話說」(抽查 2 次) | 0/2 | 0/2 | — |
| ①+②+明寫,打開思考 | 5/5 | 5/5 | 100% |
▍中文品質
---
◆ 06 下載和硬碟空間
---
◆ 07 適用建議
適合
不適合
---
◆ 08 心得總結
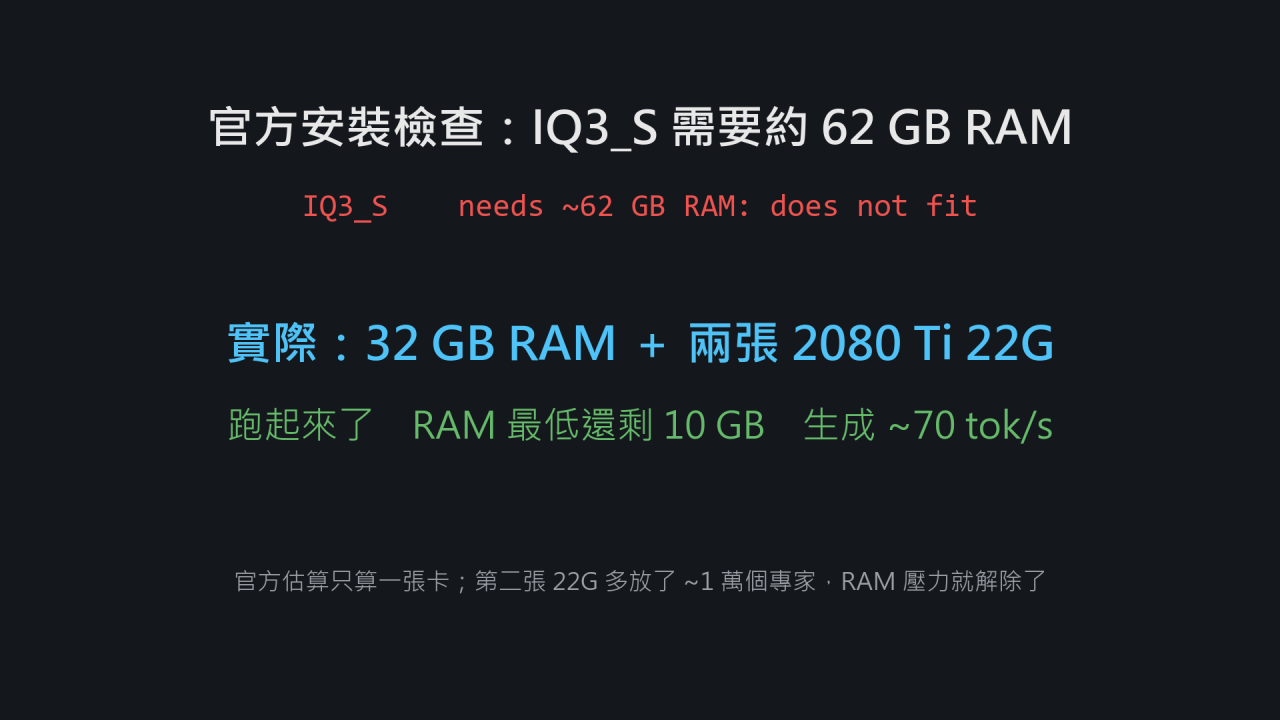
上一篇我們以為想跑 IQ3_S 就得加 RAM,實際上多一張大顯存的卡,效果比加 RAM 還好:RAM 壓力解除、快取命中率提高,速度幾乎不受影響。兩張改裝 2080 Ti 加起來 44 GB 顯存,拿來跑 125B 的 MoE 模型,算是很划算的「窮人版」推論平台。
但這次花最多時間的不是測速,而是工具呼叫。原本想「升級到最接近原版的 IQ3_S,關思考的問題應該就會改善」,結果用雲端原版一對照,才發現那是模型本身的特性。硬體能買到速度和容量,買不到模型的行為。要拿本機大模型做需要可靠工具呼叫的應用,測驗的設定一定要和正式使用時一致,而且要逐題看,不要只看總分。
(圖表與原始數據都是我們自行量測整理,歡迎討論或指正。)
線上
相關討論主題
| 主題 | 回覆 | 點閱 | 最後發表 |
|---|---|---|---|
| 0 | 475 | 2026-10-10 13:07:12 作者 Service | |
|
拓展伺服器記憶體產品組合 Crucial 首推 32GB NVDIMM 系列 作者 krader2000
|
0 | 5392 | 2018-11-01 17:44:29 作者 krader2000 |


