#1 昨天 13:07:12

Strata 實測:家用 2080 Ti 22G 跑 125B 的 Qwen3.8-Flash-Next
Strata 實測:家用 2080 Ti 22G 跑 125B 的 Qwen3.8-Flash-Next,順便和 27B 正面比較
Strata 是一個開源(MIT)推論引擎,專門讓 125B 參數的 MoE 模型 Qwen3.8-Flash-Next 在一般電腦上跑起來。做法是把常用的專家放在顯卡、其餘放在系統記憶體,再搭配 MTP 草稿層做推測解碼。官方最低需求是 12 GB 顯存、32 GB RAM。
相較於以往常見的通用型 MoE(混合專家模型)推理引擎(如標準的 llama.cpp、vLLM 或 Ollama 等),專門為超大型稀疏 MoE 模型(如 Qwen3.8-Flash-Next)設計的開源引擎 Strata 在架構與執行邏輯上有幾個關鍵的不同點:
1. 專家分層快取與記憶體混合調度(Expert Tiering & Caching)
2. CPU 與 GPU 的協同運算(Co-processing)
3. 專為 MoE 結合 MTP 草稿層的推測解碼(Speculative Decoding)
整體而言,傳統引擎追求的是「把模型整顆塞進顯存」或「標準的 CPU/GPU 分割卸載」,而 Strata 更像是針對超大型稀疏 MoE 模型量身打造的作業系統級虛擬記憶體與快取調度器,透過動態捕捉專家存取locality(局部性),打破了硬體 VRAM 容量的物理限制。
這次我手上剛好有兩台不同等級的主機、兩張 2080 Ti 22G(改裝版),就把同一個模型分別放上去跑,再拿來和平常在用的 Qwen3.8 27B 比較。
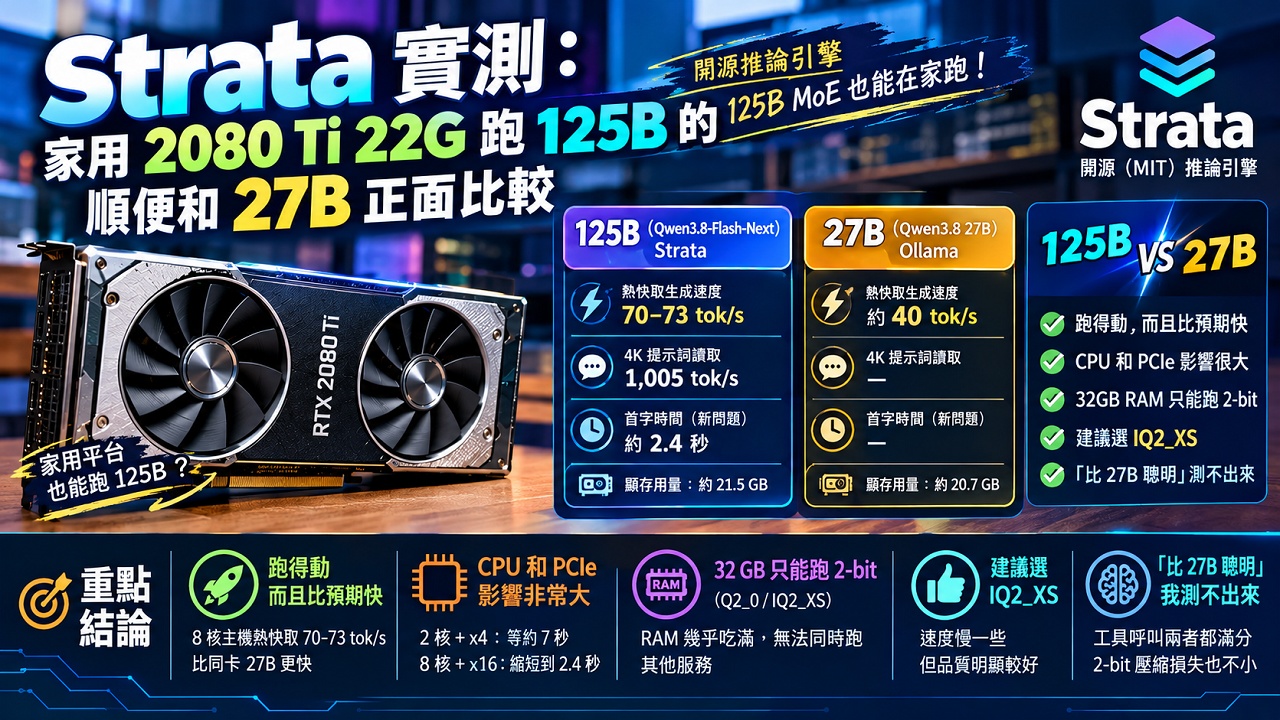
■ 先講結論
──────────────────
◆ 01 測試環境
| 項目 | 主機 A(入門) | 主機 B(主力) |
|---|---|---|
| 主機板 | MSI X470 GAMING PLUS MAX | Gigabyte X570 AORUS ELITE WIFI |
| CPU | AMD Athlon 3000G(2C/4T) | AMD Ryzen 7 5700G(8C/16T) |
| RAM | 32 GB | 32 GB |
| 顯卡 | RTX 2080 Ti 22G(改裝) | RTX 2080 Ti 22G(改裝) |
| PCIe 實際連結 | 3.0 x4 | 3.0 x16 |
| 模型存放 | SATA SSD(ext4) | NVMe(NTFS 掛載) |
| 系統 | Ubuntu 26.04.1 LTS | Ubuntu 26.04 LTS |
| 驅動 / CUDA | 595 / 13.1 | 595 / 13.1 |
──────────────────
◆ 02 安裝過程(Linux 要自己編譯)
官方的一鍵安裝(setup.sh)在 Linux 上沒有預編譯引擎,會自動改成從原始碼編譯,需要 CUDA Toolkit 13。
▍模型大小與記憶體需求(setup 會自動檢查並建議)
| 版本 | 第1分片 | 需要 RAM | 32 GB 能不能跑 |
|---|---|---|---|
| Q2_0 | 37.6 GB | 約 48 GB | 可以(低記憶體模式,顯卡放約 50% 專家) |
| IQ2_XS | 39.2 GB | 約 48 GB | 可以(低記憶體模式,顯卡放約 48% 專家) |
| IQ3_XXS | 47.0 GB | 約 60 GB | 不行 |
| IQ3_S | 54.8 GB | 約 62 GB | 不行(官方說這版才和原版模型持平) |
▍下載小技巧
──────────────────
◆ 03 效能實測
量測方式:同一份腳本,串流計時,分開記「首字時間」和「生成速度」。短問題連問三次,第一次是冷快取,後面是熱快取;另外再測一次 4K token 的長提示詞。
| A:Q2_0 | A:IQ2_XS | B:IQ2_XS | B:27B Q4(Ollama) | |
|---|---|---|---|---|
| 生成速度(熱快取) | 58–65 | 40–48 | 70–73 | 20.7–25.5 |
| 生成速度(冷快取) | 24–31 | 8–18 | 43–60 | (沒有專家快取,差不多) |
| 讀 4K 提示詞 | 580 | 524 | 1,005 | 541 |
| 4K 提示詞首字時間 | 7.0 秒 | 7.8 秒 | 4.1 秒 | 7.6 秒 |
| 關思考・新問題回完 | — | 約 7 秒 | 約 2.4 秒 | 2.4–3.6 秒 |
| 啟動到可用 | 約 2 分 | 約 2 分 | 約 80 秒 | 冷載入約 43 秒 |
| 顯存用量 | 21.5 GB | 21.5 GB | 21.5 GB | 約 20.7 GB |
| RAM 用量(執行中) | 約 23.6 GB | 約 25 GB | 約 26 GB | 約 3–6 GB |
▍27B 的 context 設定影響很大
同一個問題、同一張卡,只改 Ollama 的 num_ctx(讀 Ollama 自己回報的 eval 速度):
| num_ctx | 生成速度 | 讀提示詞 |
|---|---|---|
| 65536 | 19.4 tok/s | 73–86 tok/s |
| 8192 | 39.7 tok/s | 120 tok/s |
▍看懂這張表
──────────────────
◆ 04 品質實測
▍工具呼叫測驗
我用自己的居家語音助理情境做測驗:20 個工具、10 個情境(緊急求助、確認/否認意外、播放音樂、查天氣、調音量、查生理數值、道別、閒聊,以及「聊到別人發生意外,不應該觸發通報」這類陷阱題),每個情境跑 5 次。
| 模型 | 思考 | 整體合規率 | 安全關鍵項 |
|---|---|---|---|
| 27B Q4(Ollama) | 開 | 100% | 100% |
| 27B Q4(Ollama) | 關 | 66% | 60% |
| Flash-Next Q2_0 | 開 | 100% | 100% |
| Flash-Next Q2_0 | 關 | 78% | 50%(兩題 0/5) |
| Flash-Next IQ2_XS | 開 | 100% | 100% |
| Flash-Next IQ2_XS | 關 | 90% | 75% |
▍中文回答品質(5 個長輩日常情境 × 2 次)
──────────────────
◆ 05 思考模式的取捨
Qwen3.8-Flash-Next 預設會先思考,而且是用英文思考。
──────────────────
◆ 06 適用建議
適合
不適合
──────────────────
◆ 07 心得總結
用一張遊戲顯卡跑 125B 模型,在相同 context 下生成速度還是 27B 的 3 倍,Strata 確實讓人驚艷。專家快取的設計也很聰明:常用的專家留在顯卡,命中率可以到 98%。
但這次測試讓我更清楚一件事:這類「顯卡+RAM 混合」的引擎,瓶頸往往不在顯卡。同一張 2080 Ti,在 2 核 CPU+x4 上和 8 核+x16 上,表現差了好幾倍。想照抄的人,請先看 CPU、PCIe 寬度和 RAM 容量,不要只看顯卡。
至於「125B 有沒有比 27B 聰明」:開思考時我的測驗題兩者都滿分,分不出來;但在關思考、要求快速回應的情境下,2-bit 的 Flash-Next 工具呼叫反而比 27B Q4 穩定得多(90% 對 66%)。更完整的答案,我想等 RAM 加到 64 GB、能跑 IQ3_S 之後,再用更難的題目來回答。
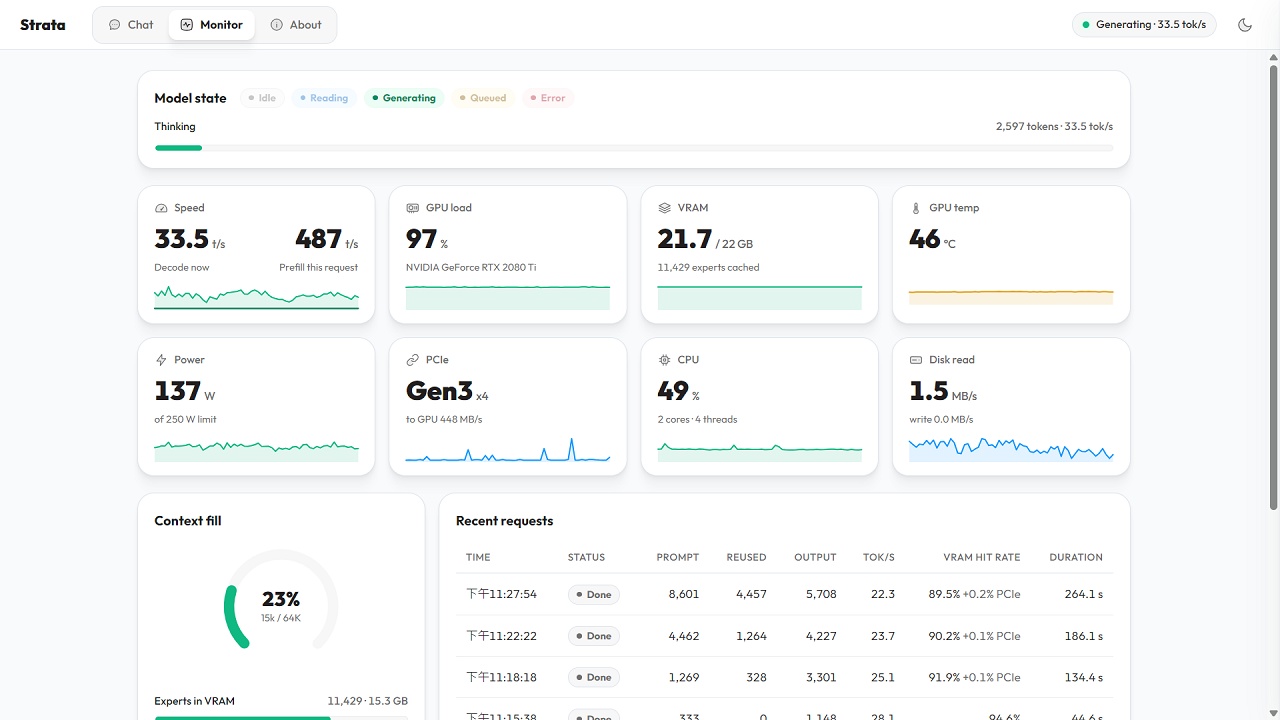
附帶一提,Strata 內建的網頁介面可以即時看到 tok/s、專家快取命中率、GPU 使用率等數據,另外還提供 /metrics(JSON 和 Prometheus 格式,指標名稱沿用 vLLM),要接 Grafana 監控很方便。
參考連結:
Strata: https://github.com/Niko1221/Strata
Qwen3.8-Flash-Next: https://huggingface.co/Qwen/Qwen3.8-Flash-Next
離線
相關討論主題
| 主題 | 回覆 | 點閱 | 最後發表 |
|---|---|---|---|
| 1 | 298 | 2026-10-05 00:54:11 作者 Service | |
|
RTX 2080 Ti 22GB 文生圖模型測試 作者 Service
|
0 | 233 | 2026-09-24 23:31:45 作者 Service |
|
RTX 2080 Ti 22GB 魔改卡到貨:燒機驗收與實測心得 作者 Service
|
0 | 539 | 2026-09-18 16:09:23 作者 Service |
|
Qwen3.8-27B 本地測試計畫 作者 Service
|
0 | 468 | 2026-09-15 21:06:41 作者 Service |
|
淘寶 2080 Ti「22GB 魔改卡」採購指南 作者 Service
|
0 | 418 | 2026-09-13 00:22:08 作者 Service |


