#1 今天 16:33:23

Strata 實測: RTX 3060 12GB+32GB RAM 跑 125B
手邊只有一張 RTX 3060 12GB 顯示卡,加上 32GB 記憶體,能不能在自己的電腦上跑大型 AI?我們用 Strata 執行 Qwen3.8-Flash-Next,實際測試回答速度、長文等待時間,以及模型能不能正確提出工具動作,再與前篇 RTX 2080 Ti 22GB 的結果放在一起看。
先說結論:能跑,但新長文需要耐心,工具動作也不能照單全收
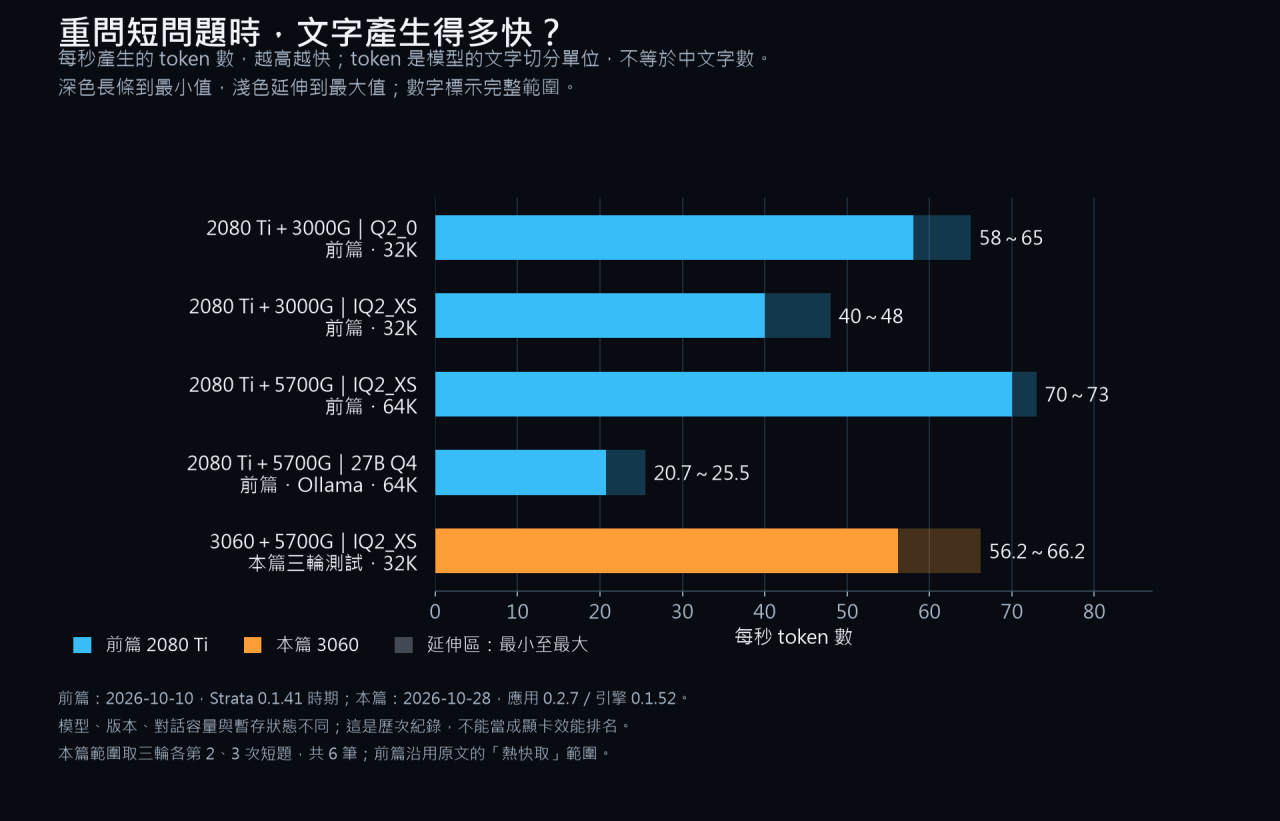
這組配置完成了三輪、共 330 次請求,沒有遇到引擎錯誤或回答傳輸中斷。重問短問題時,每秒約產生 56~66 個 token;新的中文長內容,第一次約等 34~43 秒開始輸出。token 是模型切分文字後使用的單位,可能是字、詞的一部分或標點,不能直接當成中文字數。
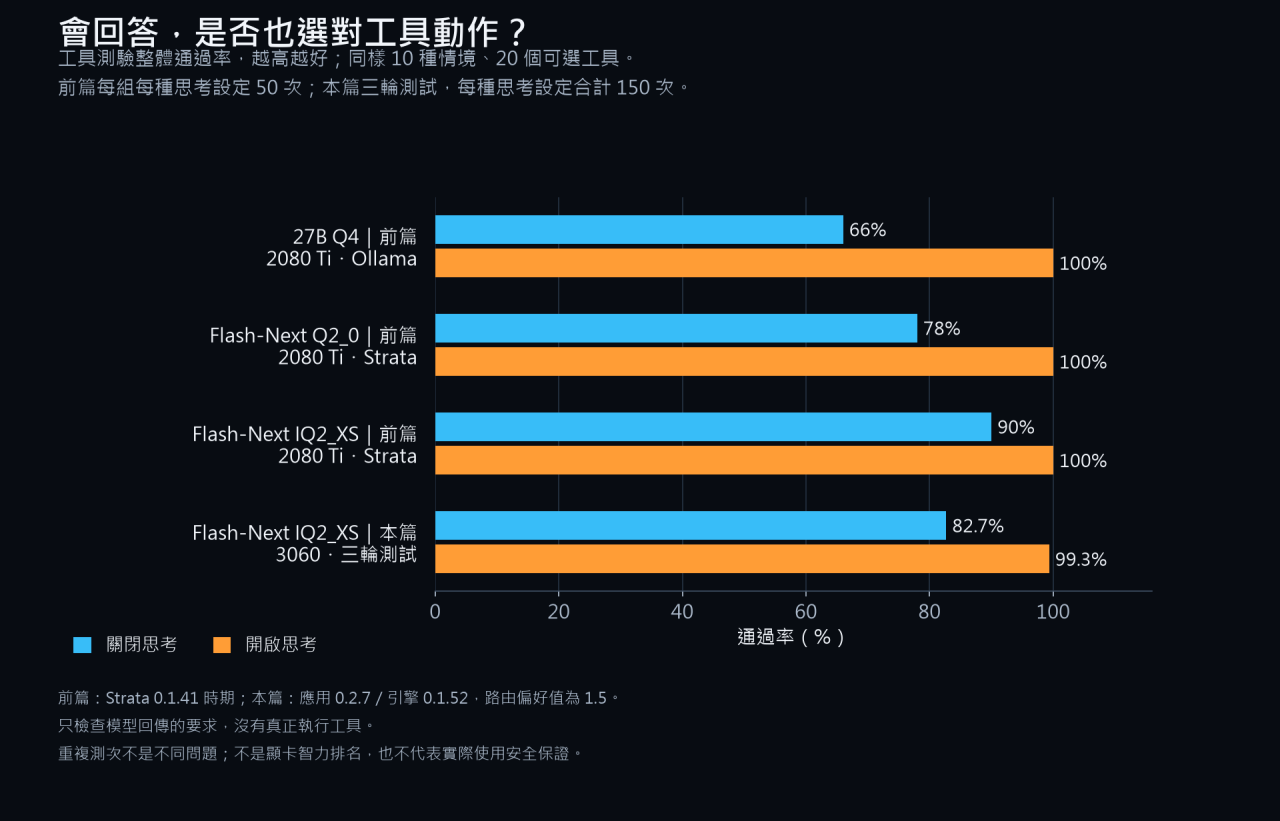
工具測驗中,開啟思考通過 149/150 次,關閉思考為 124/150 次。開啟思考的表現較好,但不是每次都正確,也可能增加等待時間。
01 測試環境與方式
Strata 是負責載入 AI 模型、分配硬體資源並產生回答的「推論引擎」。本次測試日期為 2026-10-28,固定使用以下配置。
| 項目 | 本次配置 |
|---|---|
| 處理器/主機板 | AMD Ryzen 7 5700G(8 核心、16 執行緒)/X570 AORUS ELITE WIFI |
| 主記憶體 | 32GB;另設 8GiB 磁碟交換空間 |
| 顯示卡 | RTX 3060 12GB,單卡推論 |
| 硬碟/作業系統 | NVMe 固態硬碟(透過高速介面傳輸資料)/Ubuntu 26.04;模型放在 NTFS 格式分割區(Windows 常用的檔案儲存格式) |
| 顯示卡連線/驅動 | PCIe 3.0 x16(顯示卡與主機溝通的介面規格)/NVIDIA 595.99.02 |
| 推論軟體 | Strata 0.2.7,引擎 0.1.52,官方 CUDA 13 套件(CUDA 是利用 NVIDIA 顯示卡運算的技術) |
| 模型 | Qwen3.8-Flash-Next;使用 GSQ-RCO 提供的第三方 IQ2_XS 壓縮版本 |
IQ2_XS 是一種「量化」格式,也就是以較低精度保存模型數值,減少儲存需求,但可能影響回答品質。本文測的是這個第三方壓縮版本,不能直接代表官方原始精度模型。
三輪使用相同題目與設定,每輪重新啟動模型。對話容量設為 32K(約 3 萬 2 千個 token),但長輸入實測至 4K,沒有驗證完整 32K 長度。採單人、單路文字請求,關閉圖片理解;其他設定為 8 位元對話暫存(int8 KV cache,保存已處理內容的中間資料)與多詞預測加速(MTP,設定值 4)。
三輪沒有清除作業系統的檔案暫存。啟動時間從啟動程式量到模型可接受請求,不包含下載、首次整理模型或完全冷開機;模型回答的長度也不一定相同。
02 速度:同題重問很快,新長文第一次要等
下圖的深色長條到測得的最小值,淡色延伸到最大值。前篇包含不同主機、壓縮格式與較小的 27B 模型;27B 指約 270 億個參數,Q4 是它使用的壓縮格式。
(點圖可查看大圖)
本次 3060 的短問題 A,第一次整筆時間為 6.50~17.78 秒;第二、三次重問約 1.51~2.24 秒。快很多的原因之一,是軟體可以重用已處理的相同內容,稱為「前綴快取」(prefix cache)。顯示卡裡已載入的計算模組、作業系統暫存在記憶體中的檔案資料,也會影響速度,這幾種暫存並不是同一件事。
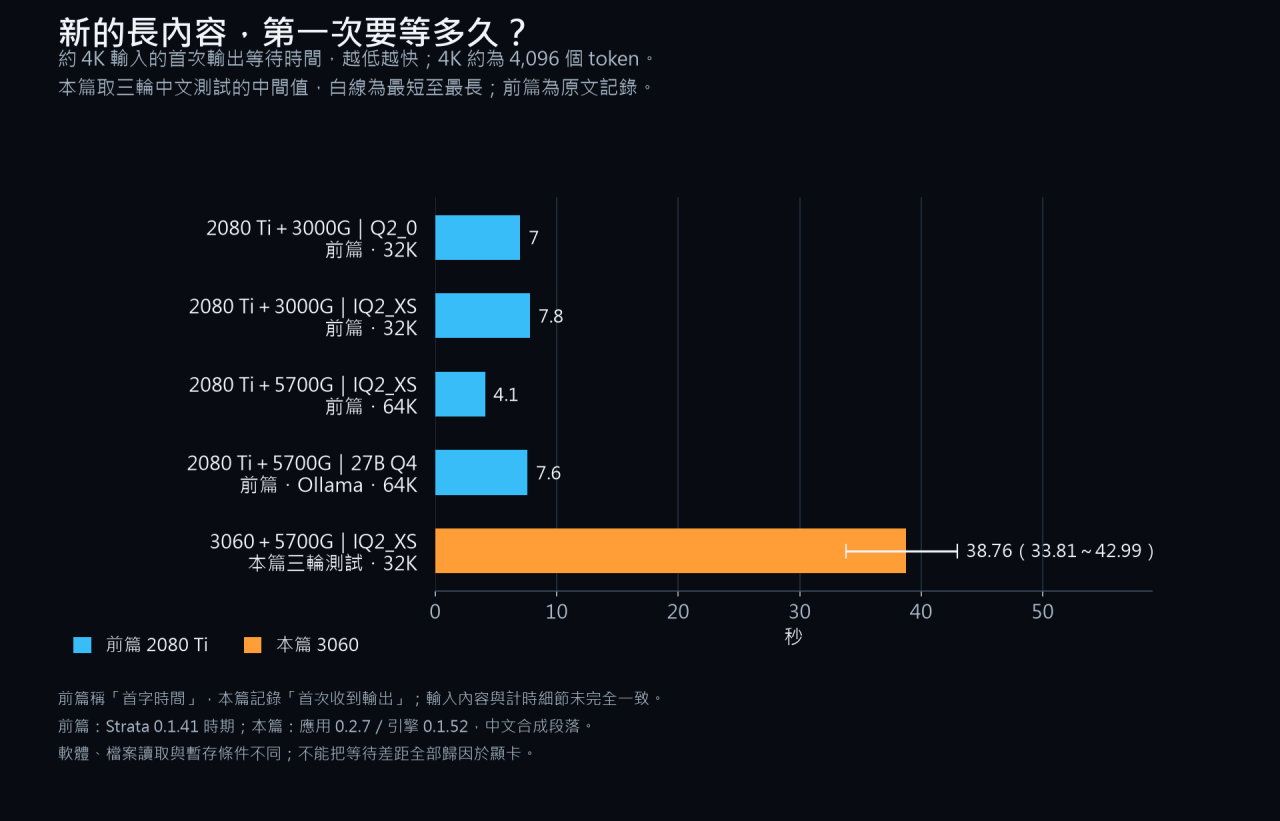
接著看新的長內容。中文測試段落由我們自行編寫,長度為 4,096 個 token;加上聊天格式後,模型實際收到 4,108 個 token。以下呈現首次開始收到輸出的等待時間,越低越快。
(點圖可查看大圖)
3060 三輪的等待時間為 33.81、38.76、42.99 秒,中間值 38.76 秒;整筆請求則花 42.83~53.58 秒。相同長文第二、三次再問,只需約 7.47~8.79 秒,但重用了 4,101 個 token 的計算結果,只新處理 7 個,不能說每次都在 8 秒內重新讀完全文。
中文長文的輸出上限設為 512 個 token,這些回答都因達上限而結束。因此這裡是在看處理與生成速度,不代表完整摘要品質已通過。
03 與 RTX 2080 Ti 22GB 的歷次結果比較
前篇測過兩台搭配改裝版 RTX 2080 Ti 22GB 的電腦。下表集中比較同樣使用 IQ2_XS 壓縮模型的結果;主力主機 B 的處理器、記憶體容量與硬碟類型最接近本次。
| 比較項目 | 前篇:2080 Ti 入門主機 A | 前篇:2080 Ti 主力主機 B | 本篇:RTX 3060 |
|---|---|---|---|
| 測試日期 | 2026-10-10 發表 | 2026-10-10 發表 | 2026-10-28 實測 |
| 處理器 | Athlon 3000G,2 核心/4 執行緒 | Ryzen 7 5700G,8 核心/16 執行緒 | Ryzen 7 5700G,8 核心/16 執行緒 |
| 主記憶體/顯示記憶體 | 32GB/22GB(改裝卡) | 32GB/22GB(改裝卡) | 32GB/12GB |
| 顯示卡連線/模型硬碟 | PCIe 3.0 x4/SATA 固態硬碟 | PCIe 3.0 x16/NVMe 固態硬碟 | PCIe 3.0 x16/NVMe 固態硬碟 |
| Strata 版本 | 0.1.41 時期 | 0.1.41 時期 | 應用程式 0.2.7/引擎 0.1.52 |
| 模型壓縮格式 | Qwen3.8-Flash-Next IQ2_XS | Qwen3.8-Flash-Next IQ2_XS | Qwen3.8-Flash-Next IQ2_XS |
| 設定的對話容量 | 32K | 64K | 32K;長輸入實測至 4K |
| 短問題重問時的生成速度 | 每秒 40~48 個 token | 每秒 70~73 個 token | 三輪測試重問每秒 56.2~66.2 個 token |
| 首次/較少暫存可用時的生成速度 | 每秒 8~18 個 token | 每秒 43~60 個 token | 三輪短問題 A 首次:每秒 10.4~28.1 個 token |
| 首次讀取約 4K 內容:開始輸出 | 前篇記錄 7.8 秒 | 前篇記錄 4.1 秒 | 中文段落中間值 38.76 秒(33.81~42.99 秒) |
| 首次讀取約 4K 內容:處理輸入速度 | 每秒 524 個 token | 每秒 1,005 個 token | 中文段落:每秒 95.8~122.6 個 token |
| 關閉思考的短回答:整筆時間 | 前篇新問題約 7 秒 | 前篇新問題約 2.4 秒 | 短題 A 首次 6.50~17.78 秒;改問 B 為 2.61~3.21 秒 |
| 啟動至可用 | 約 2 分鐘 | 約 80 秒 | 三輪測試中間值 23.38 秒(21.36~26.12 秒);已備妥模型、未清檔案暫存,與前篇啟動條件未完全一致 |
| 顯示記憶體用量 | 前篇記錄約 21.5GB | 前篇記錄約 21.5GB | 採樣最高 11,567 MiB,約 11.3 GiB |
| 主記憶體用量 | 前篇記錄執行中約 25GB | 前篇記錄執行中約 26GB | 三輪測試程式常駐最高紀錄 28.67 GiB,包含可回收檔案頁面;前篇統計口徑不同,不能直接相比 |
| 工具測驗:關閉思考 | 前篇 IQ2_XS 整體 90%;安全相關 75% | 前篇 IQ2_XS 整體 90%;安全相關 75% | 整體 82.7%;安全相關 60% |
| 工具測驗:開啟思考 | 前篇 IQ2_XS 整體與安全相關均 100% | 前篇 IQ2_XS 整體與安全相關均 100% | 整體 99.3%;安全相關 98.3% |
這張表是歷次使用紀錄,不是同條件的顯示卡排名。前篇使用 Strata 0.1.41 時期版本,本次則為應用程式 0.2.7/引擎 0.1.52;輸入內容、對話容量、資料讀取及暫存狀態也不同。尤其長文等待時間的差距,不能全部歸因於顯示卡。主記憶體的統計方式不同,也不直接計算省了多少。
04 工具測驗:思考模式表現較好,但仍會失誤
「工具呼叫」(tool calling)是指模型不只回答文字,還提出要讓程式執行哪個動作、帶入哪些資料,例如查詢數據或提出通報要求。我們準備 20 個可選工具、10 種居家語音助理情境,包括緊急求助、確認/否認跌倒、查天氣、調音量與閒聊等,檢查模型是否選對動作與參數。
本次每輪每種情境測 5 次,三輪合計每種思考設定各 150 次。測試只檢查模型回傳的要求,沒有真的執行工具或發出警報。
(點圖可查看大圖)
| 3060 三輪合計 | 整體通過 | 其中安全相關情境 |
|---|---|---|
| 關閉思考 | 124/150(82.7%) | 36/60(60%) |
| 開啟思考 | 149/150(99.3%) | 59/60(98.3%) |
思考模式會讓模型先進行推理,再產生答案;不一定立即讓使用者看到正式回答。在另外兩個短問題測試中,關閉思考約 0.69~0.96 秒開始收到答案,開啟後則分別等了 4.52 秒、46.81 秒。這只是兩題的結果,但提醒我們:任務表現與等待時間要一起衡量。
工具通過率的變化也不能解讀為顯示卡讓模型變聰明或變笨。軟體版本、壓縮格式與加速設定都可能影響答案;重複測 150 次仍然只有 10 種情境,不能當成實際使用的安全保證。
05 顯示記憶體幾乎用滿,主記憶體也要留意
| 三輪測得的項目 | 結果 |
|---|---|
| 啟動到模型可用 | 21.36~26.12 秒,中間值 23.38 秒 |
| 顯示記憶體最高用量 | 11,567 MiB,約 11.3 GiB |
| 程式常駐記憶體最高紀錄 | 28.67 GiB,包含可回收的模型檔案頁面 |
| 整台電腦磁碟交換空間最高用量 | 各輪為 3.07、3.65、3.18 GiB |
| 顯示卡功耗/溫度最高值 | 約 170 瓦/75°C |
新版使用「檔案映射」(memory mapping),讓程式透過記憶體位址讀取模型檔案,系統再按需求載入。同一份資料可能同時出現在程式用量與系統檔案暫存統計中,不能直接相加。28.67 GiB 是系統記錄的程式常駐記憶體高水位,包含可以回收的檔案頁面,不等於都是程式不能釋放的資料。
資源數據約每秒記錄一次,可能漏掉短暫尖峰;常駐記憶體另採系統保存的最高紀錄。功耗只量顯示卡,沒有量插座端整台電腦的耗電。
結論 適合誰?還有哪些限制?
如果你已有 12GB 顯示卡、32GB 記憶體與 NVMe 固態硬碟,想在自己電腦上體驗大型模型的文字生成,這次結果顯示可以嘗試。要接受新的長內容可能先等數十秒,同題重問的速度通常較漂亮。啟動時仍會出現容量低於建議、可能變慢或記憶體不足的提醒,不能把這次成功運作當成「32GB 永遠足夠」的保證。
如果需求是每次新問題都要很快、多人同時使用,或讓 AI 控制重要動作,仍需要針對實際用途驗證。這次不是長時間穩定性測試,也沒有測試與其他大型模型同時運作。
回答看起來通順,也不等於切題或正確。我們在中文日常情境中看過答非所問,以及把一人一貓稱為「兩個人」的語意問題;單題程式測試即使通過基本檢查,也不能代表所有邊界情況都正確。
另外,Strata 的預設加速會偏好已載入顯示卡的「專家」計算模組,以減少資料搬移。本次 3060 使用的路由偏好值為 1.5;它可能改變模型選用的計算模組與答案,不只是把完全相同的結果算快一點。因此選擇設定時,除了速度,也應檢查回答品質。
參考資料
• 前篇:RTX 2080 Ti 22GB 跑 Strata 實測
• Strata 0.2.7 官方版本說明
• Qwen 官方模型頁面
離線
相關討論主題
| 主題 | 回覆 | 點閱 | 最後發表 |
|---|---|---|---|
| 0 | 274 | 2026-10-22 11:56:31 作者 Service | |
| 0 | 830 | 2026-10-10 13:07:12 作者 Service | |
| 1 | 675 | 2026-10-05 00:54:11 作者 Service | |
|
拓展伺服器記憶體產品組合 Crucial 首推 32GB NVDIMM 系列 作者 krader2000
|
0 | 5422 | 2018-11-01 17:44:29 作者 krader2000 |


