數位天堂

Nokia:科技始終來自於人性; 拜耳:如果文明不能使我們更相愛,那科技便失去意義!
歡迎您的加入,讓我們一起討論科技與環保的整合應用...

您尚未登入。

#1 昨天 10:02:12

Service
天使
註冊日期: 2007-07-15
文章數: 352
目前積分 :   0 

本地跑 DeepSeek V4.1 Flash Coder 程式快六成 中文卻翻車?

上一篇我們在雙 2080 Ti 22G、32 GB RAM 上跑 DeepSeek V4.1 Flash,結論是瓶頸在資料供應:專家放不進顯存,時間大多花在 CPU 計算和等硬碟。

Strata v0.2.10 加入了 ISTA-DAS 的 Coder 版:每層專家從 384 個砍到 192 個,模型檔只剩 72 GB。專家少一半,顯存和 RAM 能放下的比例就變高,理論上應該快不少。這篇記錄我們實測的結果:寫程式確實快了約六成,但中文會出問題。
https://digiland.tw/uploads/3_20261105_225326_ds41-coder.jpg

■ 先講結論

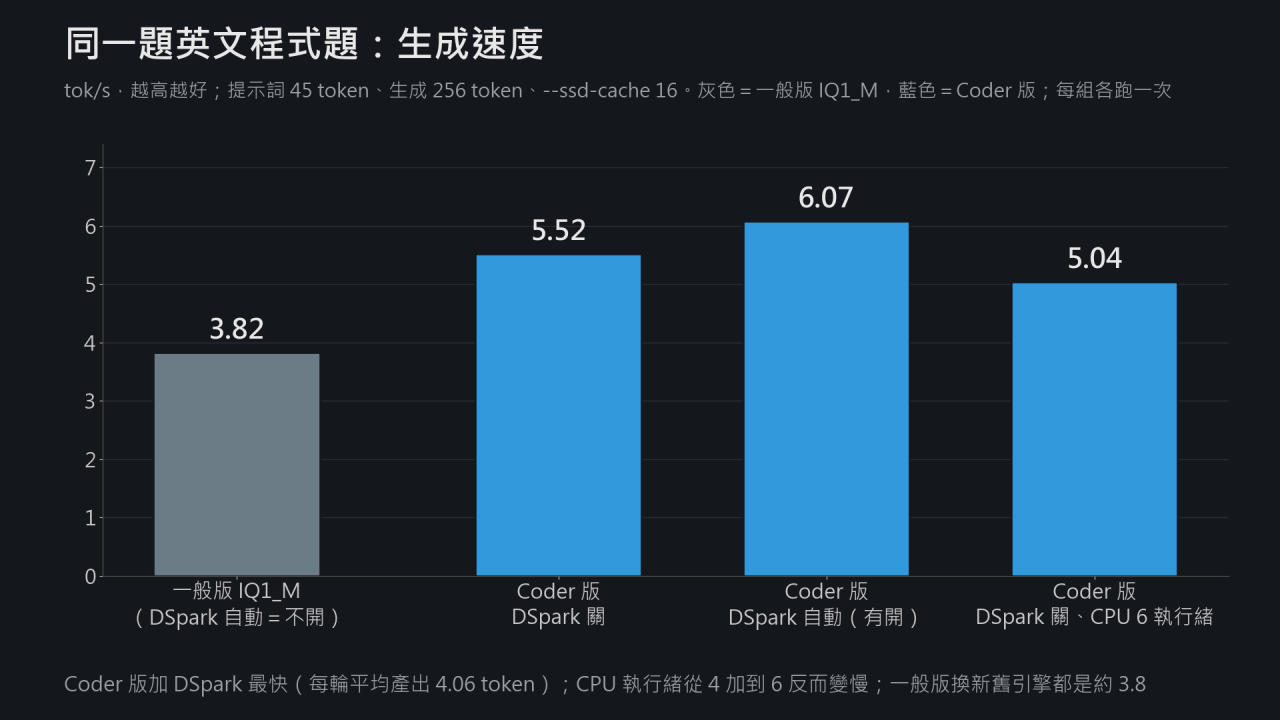
  • 同一題英文程式題,Coder 版 6.07 tok/s,一般版 3.82 tok/s:都用引擎預設的 DSpark 自動,Coder 版快約 59%;兩邊都關掉 DSpark 比,Coder 版 5.52 tok/s,仍快約 45%。
  • 寫程式的品質沒問題:這次檢查的程式碼邏輯正確,型別標註、docstring、空輸入處理都有。
  • 中文不建議用 Coder 版:要求繁體中文卻一律回簡體、常出現疊字,還有兩次崩成同一個字重複到結束。崩掉時速度會「看起來」特別快,那種數字不能採信。
  • DSpark 這次有用:Coder 版寫程式時,引擎會自動開啟 DSpark,每輪平均產出 4.06 個 token,比關掉快約 10%。上一篇的一般版是開了反而慢。
  • CPU 執行緒開到 6 反而變慢:我們的 CPU 是 6 核 6 緒,引擎預設只用 4 個;手動加到 6,Coder 版從 5.52 掉到 5.04 tok/s。


  • ---

    ◆ 01 Coder 版是什麼

    依官方 v0.2.10 的說明:
  • 這是 ISTA-DAS 為寫程式用途做的版本:每層 384 個專家只保留 192 個,量化方式沿用 2.00 bpw 那組(pack-info 顯示專家平均約 1.94 bpw)。官方沒有說明保留哪些專家。
  • 模型本體 72.1 GB;Engram 查詢表(110.6 GB)和 DSpark 草稿模型(8 GB)和一般版共用,第一次下載合計約 191 GB。
  • 官方公布的品質:和原版相比的 KL 0.397、困惑度 4.645(原版 3.140),61 題測試通過 54 題。名稱就叫 Coder,本來就是為寫程式設計的。
  • 官方速度:單張 Radeon AI PRO R9700(32 GB)配 32 GB RAM 約 18.5 tok/s。那是另一套平台的記錄,不是同條件對照。


  • ---

    ◆ 02 準備:只多下載 72 GB
  • 引擎:v0.2.10 的 DeepSeek 引擎(0.1.56)官方預編仍然只有 sm_86/sm_89/sm_120,2080 Ti 照上一篇的方式自己編 sm_75,指令不變,約 6 分鐘。
  • 下載:只需要 Coder 版自己的 5 個分片(第 1 個是 5.8 MB 的詮釋資料,其餘 4 個是模型)。Engram 和識圖模組,setup.py 都接受我們上一篇已經下載的那份,Coder 版 repo 裡的 Engram 校驗值雖然不同,但 setup.py 有列為同一份資料。
  • 打包:和一般版有一個差別,詮釋資料要用 Coder 版自己的第 1 個分片(--engram-meta 指向它),熱門專家清單換成 profile-coder.bin。打包一樣只寫索引,幾秒鐘、不到 10 MB。
  • pack-info 的結果:專家總量 66 GB,每個專家 8.6 MB(一般版 7.5 MB),每生成一個 token 要讀約 2.06 GB 的專家。


  • ---

    ◆ 03 中文:會變簡體、疊字,甚至崩掉

    我們先沿用上一篇的中文題「用繁體中文約三百字說明,為什麼 MoE 模型可以用比總參數量小很多的顯示卡記憶體來執行」,結果:
  • 題目要求繁體中文,回答幾乎都是簡體(長文摘要那組只有開頭一句是繁體)。
  • 常出現疊字,例如「显显卡记忆」。
  • 6 組測試裡有 2 組崩掉,回答到一半開始重複同一個字,直到 256 個 token 用完:
  • 专家权重可分分存储:不同专家可以 reside在不同显显卡或显显卡,只激活的专家需要显显显显显显显显显显显显显显显显显……

    要特別注意:崩掉的那兩組速度是 8.00 和 7.49 tok/s,比正常的快很多。一直重複同一個字時,用到的專家幾乎都在快取裡,DSpark 也很好猜,所以數字好看但沒有意義。看速度之前,一定要先看輸出內容。

    沒崩的中文組約 3.5–5.0 tok/s,但品質如上,我們不建議拿 Coder 版做中文用途。我們推測是砍掉的專家裡,有不少是中文一般寫作會用到的,但沒有進一步驗證。

    ---

    ◆ 04 寫程式:同一題對照

    改用英文程式題:「寫一個 Python 函式 merge_intervals,合併重疊的閉區間並排序,要有型別標註、docstring、處理空輸入,再加三個 pytest 測試」。一般版也跑同一題,條件完全相同。
    https://www.digiland.tw/uploads/3_20261103_230400_02_code_speed.png

    模型DSparkCPU 執行緒生成每 token 讀硬碟
    一般版 IQ1_M(引擎 0.1.55)自動(不開)43.77 tok/s226 MB
    一般版 IQ1_M(引擎 0.1.56)自動(不開)43.82 tok/s222 MB
    Coder 版關45.52 tok/s163 MB
    Coder 版自動(有開)46.07 tok/s125 MB
    Coder 版關65.04 tok/s159 MB
    Coder 版自動(有開)65.90 tok/s124 MB
  • 測試條件:兩張卡、--ssd-cache 16、關思考;提示詞 45 token、生成 256 token;全部在同一次開機內連續測,每組各跑一次。
  • 兩個模型寫出的程式碼都正確,一般版還多給了使用範例。
  • 一般版用新舊引擎幾乎一樣(3.77 對 3.82),所以速度差距來自模型,不是引擎升級。
  • 一般版寫程式(3.8 tok/s)比它做中文問答(上一篇的 4.8 tok/s)慢。題目不同,速度就會差這麼多,所以比較時一定要用同一題。


  • ---

    ◆ 05 為什麼快:等硬碟的時間少了

    https://www.digiland.tw/uploads/3_20261103_230400_03_time_per_token.png

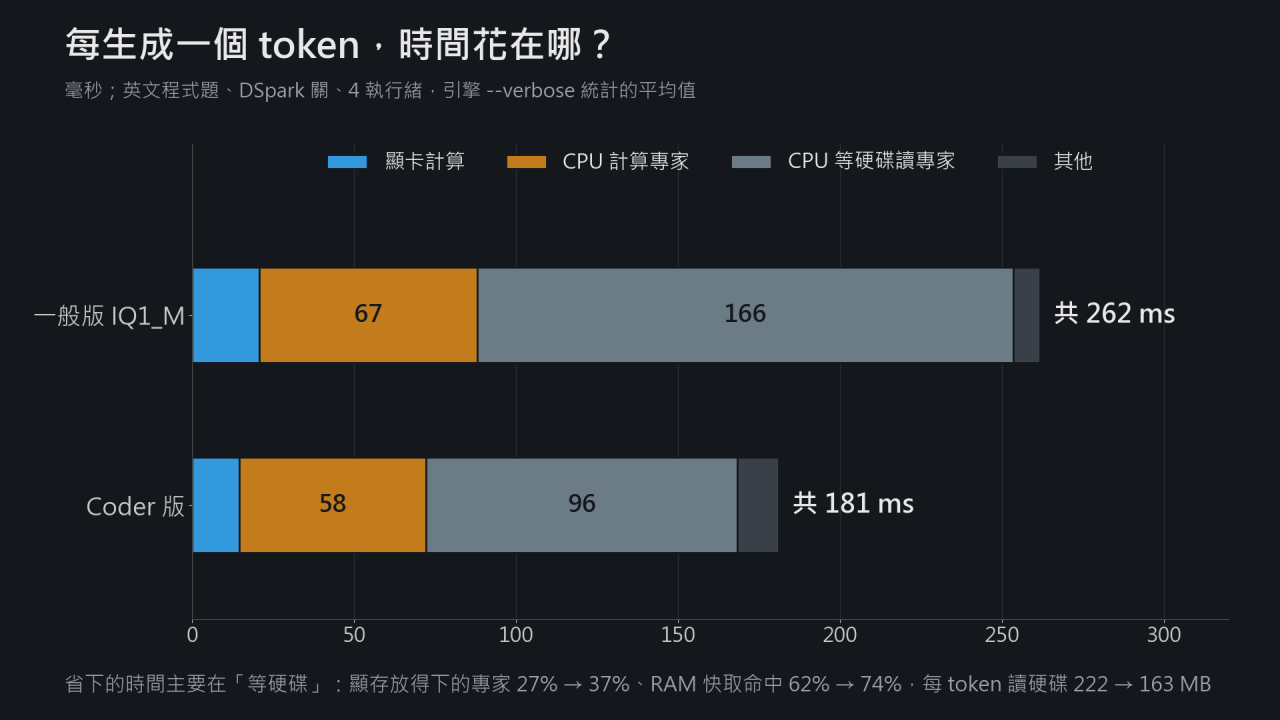
    比較兩邊都關 DSpark、4 執行緒的時間拆解:
  • 顯卡計算本來就很快,兩邊都只有 15–21 ms。
  • CPU 計算專家從 67 ms 降到 58 ms,差別不大。
  • 主要省在等硬碟:166 ms 降到 96 ms。專家總量少一半,兩張卡放得下的比例從 27% 升到 37%(3,008 個專家),RAM 快取命中率從 62% 升到 74%,每 token 讀硬碟從 222 MB 降到 163 MB。
  • 兩張卡的平均使用率仍然只有 25% 左右,瓶頸還是在資料供應,只是供應的量變少了。


  • ---

    ◆ 06 DSpark:這次開了比較快

    上一篇的一般版,引擎在「自動」下不會開 DSpark,我們強制開啟後反而慢 12%。Coder 版的專家總量比較小,引擎在「自動」下就會開啟,寫程式時的結果是:
    Coder 版(4 執行緒)生成每輪產出每 token 讀硬碟
    DSpark 關5.52 tok/s1 token163 MB
    DSpark 自動(有開)6.07 tok/s4.06 token125 MB
    程式碼的結構很規律,草稿很好猜,一輪平均能產出 4 個 token 以上。實測每 token 讀硬碟反而從 163 MB 降到 125 MB,我們推測是一次驗證的幾個 token 挑到的專家重複得多,平均下來每個 token 讀得更少。中文題的草稿每輪只產出約 1.6 個 token,我們推測效益會小很多,但這次沒有做中文題的同條件對照。

    ---

    ◆ 07 CPU 執行緒:開滿反而慢

    我們的 Ryzen 5 3500X 是 6 核 6 緒,引擎預設只用 4 個執行緒計算專家。手動用 --cpu-threads 6:
  • DSpark 關:5.52 → 5.04 tok/s(慢 9%)
  • DSpark 自動:6.07 → 5.90 tok/s(慢 3%)

  • 引擎同時還有送指令給兩張顯卡、讀硬碟的執行緒在跑,我們推測 6 個計算執行緒把它們擠掉了。至少在 6 核 6 緒的 CPU 上,維持預設就好。每組只跑一次,小幅差距可能在誤差範圍內,但兩組方向一致。

    ---

    ◆ 08 該選哪一版?
  • 主要寫程式:Coder 版加 DSpark,在這台約 6 tok/s,比一般版快約六成,下載也少一半。
  • 中文問答、整理文件:用一般版。Coder 版的中文品質不適合。
  • 兩版的 Engram 和 DSpark 草稿模型共用,硬碟夠的話可以兩版都放,依用途切換。
  • 不管哪一版,看速度數字前都先看輸出內容;輸出崩掉時的速度沒有參考價值。


  • ---

    ■ 參考連結
  • Strata(本文使用的推論引擎):https://github.com/Niko1221/Strata
  • Strata v0.2.10 release(加入 ISTA-DAS Coder):https://github.com/Niko1221/Strata/releases/tag/v0.2.10
  • 模型 DeepSeek V4.1 Flash 1017 GSQ-RCO Coder GGUF(ISTA-DASLab):https://huggingface.co/ISTA-DASLab/Deep … Coder-GGUF
  • 一般版 GSQ-RCO GGUF(ISTA-DASLab,對照組 IQ1_M):https://huggingface.co/ISTA-DASLab/Deep … Q-RCO-GGUF

  • ■ 同系列文章
  • 32GB RAM 本地跑 DeepSeek V4.1 Flash 初體驗:https://digiland.tw/viewtopic.php?id=3522
  • Strata 實測:家用 2080 Ti 22G 跑 125B 的 Qwen3.8-Flash-Next:https://www.digiland.tw/viewtopic.php?id=3512
  • 續篇:32 GB 記憶體+雙 2080 Ti 22G 跑 Strata IQ3_S:https://www.digiland.tw/viewtopic.php?id=3516
  • 雙 2080 Ti 跑 DeepSeek V4.1 Flash:瓶頸在資料供應:https://www.digiland.tw/viewtopic.php?pid=23030#p23030


  • (圖表與原始數據都是我們自行量測整理,歡迎討論或指正。)


    NVIDIA DGX SPARK

    離線


    相關討論主題

    主題 回覆 點閱 最後發表
    0 113 2026-11-04 14:17:41 作者 Service
    0 1109 2026-10-10 13:07:12 作者 Service
    <Flash Game>快打旋風2 作者 Aven  [ 1 2 ]
    16 58248 2019-07-19 23:49:33 作者 hemmis
    <Flash Game>泡泡龍 作者 Aven  [ 1 2 3 ]
    26 78727 2019-03-24 17:15:36 作者 fishkoka
    <Flash Game>雷電 作者 Aven
    8 30621 2018-10-30 00:16:33 作者 s0522boy

    友情連結

    論壇頁尾

    Powered by PunBB
    © Copyright 2018 Rickard Andersson
    RSS Feed