#1 昨天 23:04:09

CosyVoice 3 TTS 三卡實測:3060 12G / 3060 Ti 8G / 2080 Ti 22G
CosyVoice 3 TTS 三張顯卡實測:RTX 3060 12G / 3060 Ti 8G / 2080 Ti 22G(改)
前言
前一篇完成 RTX 2080 Ti 22GB 魔改卡的燒機與顯存驗收後,這次把它正式拉進實際 AI 工作負載,看看這張「老世代+大顯存」的顯卡,在語音合成這類與即時互動密切相關的任務上,到底能跑到什麼程度。
這次沒有只測 2080 Ti,而是加入 RTX 3060 12GB 與 RTX 3060 Ti 8GB,使用相同的 CosyVoice 3 + vLLM 推理環境進行比較,並把測試重點放在 RTF、串流首包延遲、VRAM 使用量、顯存頻寬、溫度、並發能力,以及 vLLM、TensorRT、WSL2 等不同軟體條件所造成的差異。
這次測試也刻意避開一個很容易出現的誤區:
GPU 規格比較,不等於實際應用效能比較。
2080 Ti 的理論顯存頻寬明顯高於 3060 Ti,22GB 顯存也遠大於 8GB;但在實際 TTS 工作負載中,頻寬、CUDA 核心數、kernel 啟動延遲、推理框架與資料傳輸方式,全部可能成為瓶頸。
因此這篇文章不只想回答「哪張卡比較快」,更想找出一個實際問題:
如果目標是架設一台長時間運作的本地 AI 語音服務,到底什麼才是真正影響使用體驗的瓶頸?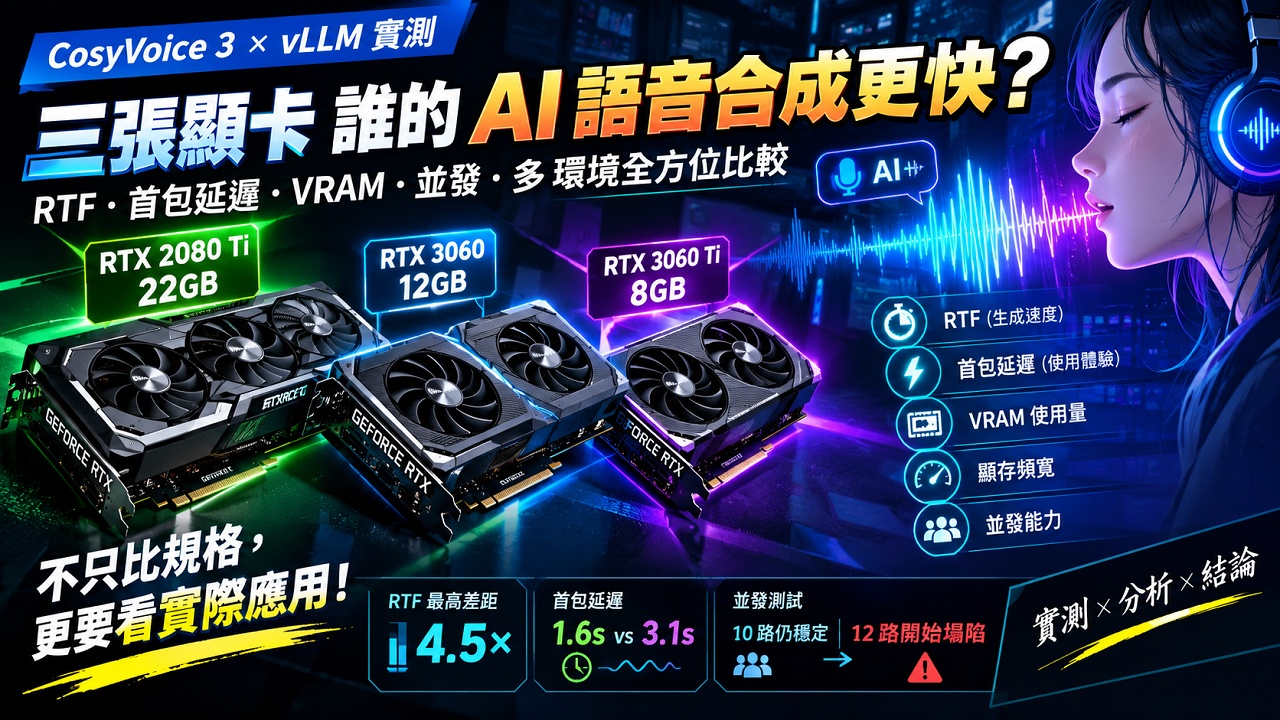
以下測試全部以實際執行結果為主,並盡可能使用相同測試方法進行比較。數據適用於本次測試環境,不代表不同版本的 CUDA、PyTorch、vLLM、CosyVoice 或不同硬體平台一定會得到完全相同的結果。
同一套 CosyVoice 3 + vLLM 加速管線,換三張不同世代、不同定位的卡實測 RTF、VRAM 用量與串流首包延遲。附燒機驗收數據、踩過的五個測量陷阱,以及每張卡實際可用的設定值。
測試對象:RTX 3060 12G / RTX 3060 Ti 8G / RTX 2080 Ti 22G(改裝顯存)
引擎:CosyVoice 3 + vLLM(自迴歸段加速)
系統:原生 Ubuntu 26.04(非 WSL)
──────────────────────────────
■ 先講結論
──────────────────────────────
◆ 01 硬體規格
| 規格 | 3060 12G | 3060 Ti 8G | 2080 Ti 22G(改) |
|---|---|---|---|
| 架構 | Ampere GA106 | Ampere GA104 | Turing TU102-300A |
| CUDA核心/SM數 | 3584 / 28 | 4864 / 38 | 4352 / 68 |
| VRAM/位寬 | 12GB/192-bit | 8GB/256-bit | 22GB(改)/352-bit |
| 理論頻寬 | 360 GB/s | 448 GB/s | 616 GB/s(最高) |
| FP32理論算力 | 12.74 TFLOPS | 16.2 TFLOPS(最高) | 13.45 TFLOPS |
| BF16支援 | ✅ | ✅ | ❌ |
| 實測功耗上限 | 170W(功耗牆) | 200W(溫度牆) | 260W(功耗牆) |
──────────────────────────────
◆ 02 TTS 服務層實測(重點數據)
三張卡同一套設定(FP16 + ONNX 前端跑 CPU + vLLM),同一支腳本 bench_tts.sh 10、n=50,皆為原生 Ubuntu,日期分別為 2026-09-09 / 09-10 / 09-18,方法完全一致,可直接互相比較。
| GPU | RTF | 串流首包 | TTS VRAM |
|---|---|---|---|
| 3060 12G | 0.330 | 約 1.72s | 5,957 MiB |
| 3060 Ti 8G | 0.24 ★ | 約 1.27s | 4,753 MiB |
| 2080 Ti 22G | 0.250 | 1.23–1.27s | 5,000 MiB |
⚠ VRAM fraction 是比例式,必須每卡重算
vLLM 的顯存分配參數(COSY_VLLM_GPU_FRAC)是「佔總顯存的比例」,不是固定 MiB。沿用舊卡的比例在大顯存卡上會分配過量、在小顯存卡上會直接 OOM,且不影響速度只浪費顯存。三張卡各自校準後的正確值:
| 設定 | 3060 12G | 3060 Ti 8G | 2080 Ti 22G |
|---|---|---|---|
| COSY_VLLM_GPU_FRAC | 0.27 | 0.40 | 0.15 |
| 實際 TTS VRAM | 5,957 MiB | 4,753 MiB | 5,000 MiB |
──────────────────────────────
◆ 03 燒機驗收數據
附上是因為「跑得動」跟「跑得快」是兩件事——尤其 2080 Ti 是後天改裝顯存的卡,容量造假或焊接不良通常第一輪燒機就會爆錯,不會等到半夜跑推論才吐亂碼。
| 項目 | 3060 12G | 3060 Ti 8G | 2080 Ti 22G |
|---|---|---|---|
| VRAM全容量測試 | 60min/62,686次/0 err | 30min/64,143次/0 err | 30min/22,357次/0 err |
| 頻寬 寫入(達成率) | 316 GB/s (88%) | 390.5 GB/s (87%) | 467–472 GB/s (76%) |
| 頻寬 讀取驗證 | 318–320 GB/s | 393–394 GB/s | 495–505 GB/s |
| 峰值溫度/熱餘裕 | 77°C / 16°C | 85°C / 8°C | 81°C / 8°C |
| 限制因素 | 功耗牆 | 溫度牆 | 功耗牆 |
──────────────────────────────
◆ 04 軟體優化比硬體本身更有效
▍vLLM:同一張卡,4 倍差距
CosyVoice 的瓶頸出在自迴歸產生 token 的階段,這段 GPU 使用率只有 40–55%——是 kernel 啟動延遲卡住,不是算力卡住。vLLM 的 CUDA Graph 把大量小 kernel 呼叫打包成一次提交,正好打在這個痛點上。在 3060 Ti 上同一顆卡、同一份 FP16 設定做 A/B:
| 測試句 | FP16(無vLLM) | FP16+vLLM | 提升 |
|---|---|---|---|
| 打招呼 | RTF 1.49 | RTF 0.33 | 4.45× |
| 跌倒確認句 | RTF 1.20 | RTF 0.32 | 3.79× |
| 天氣問答 | RTF 1.19 | RTF 0.31 | 3.85× |
▍作業系統一樣有 27% 差距
同一張 3060 Ti,只換系統(WSL2 → 原生 Ubuntu 26.04),沒動硬體:
| 指標 | WSL2 | 原生 Ubuntu 26.04 |
|---|---|---|
| TTS RTF(打招呼/跌倒句) | 0.33 / 0.32 | 0.24 / 0.24 (快27%) |
| 端到端首聲 | 3,159 ms | 2,112–2,206 ms |
──────────────────────────────
◆ 05 RTF 低不代表體感快
把本地 CosyVoice(RTF 0.24–0.32,vLLM 加速後)跟雲端 BytePlus TTS 直接量測端到端首包(WebSocket 收到第一個音訊 frame 的時間),15 次取中位數:
| TTS | 中位數 | 最快 | 最慢 |
|---|---|---|---|
| 雲端 BytePlus(雙向串流) | 1,630 ms ★ | 1,117 | 4,577 |
| 本地 CosyVoice(vLLM) | 3,159 ms | 2,209 | 14,063 |
首包延遲 ≈ 630ms(固定架構成本)+ 每秒音訊 × 160–210ms
對同一張卡(3060 Ti,原生 Ubuntu 生產環境)精確量測呼叫邊界後發現:延遲 = 一個固定成本 + 與音訊長度成正比的生成時間,而這個 ~630ms 固定成本是模型架構本身(flow-matching 的固定 ODE 步數 + 聲碼器),跟顯存頻寬無關,換卡砍不掉。實務上唯一免費的優化是讓第一句合成的文字盡量短,因為這個固定成本是「每次呼叫」付一次,不是「每個字」都要付。
──────────────────────────────
◆ 06 並發上限
3060 Ti 上測試同時送多少請求會開始塌陷(拿掉不必要的全域鎖之後,模型本身是 thread-safe 的):
| 並發數 | 最慢一筆 | 平均/請求 | 錯誤數 |
|---|---|---|---|
| 4 | 4.7s | 1,169 ms | 0 |
| 6 | 7.0s | 1,175 ms | 0 |
| 8 | 9.9s | 1,243 ms | 0 |
| 10 | 12.3s | 1,233 ms | 0 |
| 12 | 49.4s ⚠ | 4,118 ms ⚠ | 0 |
──────────────────────────────
◆ 07 五個會讓你量到假數字的陷阱
① Windows 顯卡驅動會偷偷把顯存溢到系統記憶體
536+ 版驅動的「CUDA System Memory Fallback」在 VRAM 不足時不會報 OOM,而是靜默透過 PCIe 溢到系統 RAM(頻寬低一個數量級),完全沒有錯誤訊號。在一張 6GB 卡上實測:模型需求約 6.7GB,結果真的溢出,某句合成從 3.28s 暴增到 100s,一開始被誤判成「FP16 有問題」,後來才抓到是這個驅動行為。這個陷阱只在 Windows 上發生,是換到原生 Linux 的理由之一。
② torch.cuda.max_memory_allocated() 量出來的 VRAM 是假的
它不含 CUDA context、cuDNN/cuBLAS workspace,也不含 onnxruntime 自己的顯存池(CosyVoice 的語音 tokenizer 跟聲紋模型是用 ONNX Runtime 跑在 CUDA 上,完全在 PyTorch 的統計範圍之外)。用這個函式量,容易低估將近一半。一律改用 nvidia-smi 才是真實數字。
③ GPU fraction 參數是比例式,換卡等於換算法
同一個比例在不同顯存容量的卡上結果完全不同,可用資源變多反而可能因為分配過度而排擠掉別的服務,甚至 OOM。每次換卡都要重新校準,不能延用舊值。
④ WSL2 的延遲稅算在「軟體」帳上,卻常被誤判成「硬體不夠力」
同一張卡在 WSL2 跟原生 Linux 上,理論算力完全一樣(FP16 算力實測等於理論值),純粹是虛擬化層的 kernel 提交延遲拖慢啟動密集型負載。在下結論「這張卡不夠快」之前,先確認測試環境本身有沒有這一層稅。
⑤ RTF 贏不代表數字沒有代價,一定要做真人聽感測試
TensorRT 把 RTF 壓到全場最低(1.17),純看數字是勝利,但實際聽起來音質明顯劣化(顫抖)。任何「加速後數字變好看」的結果,上線前都應該實際聽一遍,不能只看 benchmark 輸出的數字。
──────────────────────────────
◆ 08 最終可用設定
三張卡最後都收斂到同一套組合,差別只在 COSY_VLLM_GPU_FRAC:
COSY_ONNX_CPU=1           # 語音 tokenizer 的 ONNX 前端丟 CPU 跑,省顯存
COSY_FP16=1               # 單這項對短句就有 ~1.6× 提升
COSY_TRT=0                # TensorRT 已驗證會傷音質,關閉
COSY_VLLM=1                # 4 倍提升的主要來源
COSY_VLLM_GPU_FRAC=0.40    # 依卡調整:3060Ti=0.40 / 3060 12G=0.27 / 2080Ti 22G=0.15
COSY_NO_LOCK=1
COSY_MAX_CONCURRENCY=4     # 實測數據支持拉到 10,12 開始塌陷
VLLM_NO_USAGE_STATS=1
DO_NOT_TRACK=1             # vLLM 預設會回傳使用統計,關掉
三張卡的燒機、bench_tts.sh 對照與 vLLM/TensorRT 的 A/B 測試皆為原始資料整理,數字皆標註測試方法與日期;不同方法量出的數字不放進主表,避免誤導比較。
總結
這次三張 NVIDIA 顯卡的 CosyVoice 3 實測,得到一個相當有意思的結果:
顯存最大的 2080 Ti 22GB,並沒有在 TTS 速度上明顯領先 3060 Ti 8GB。
在本次測試環境中,3060 Ti 的 RTF 約 0.24,2080 Ti 約 0.25,兩者幾乎在同一個級距;反而是 3060 12GB 以約 0.33 落後。這說明對 CosyVoice 這類工作負載而言,單純增加顯存頻寬並不一定能等比例轉換成 TTS 效能,GPU 核心數量、kernel 啟動效率與推理框架的影響可能更大。
但這並不代表 2080 Ti 22GB 沒有價值。
它最大的優勢仍然是22GB 顯存容量。對需要較大模型、較大 batch、較大 KV cache,或希望同一張卡同時容納多個 AI 工作負載的使用者而言,8GB 與 22GB 所能做的事情仍然存在明顯差距。
這次測試真正令人印象深刻的,反而是「軟體環境」的重要性。
同一張 3060 Ti,在沒有 vLLM 與啟用 vLLM 的情況下,RTF 可以出現數倍差距;同一張 GPU 從 WSL2 改成原生 Ubuntu,也可以觀察到明顯的延遲改善。換句話說,當 GPU 本身已經不是主要瓶頸時,繼續換更貴的顯卡,未必比把推理架構整理好更有效。
另外,這次測試也再次證明:
RTF 是重要指標,但不是使用者體驗的全部。
本地 CosyVoice 的 RTF 已經相當漂亮,但目前服務架構的端到端首包延遲仍然高於雲端串流服務。真正的問題不是單純「GPU 不夠快」,而是從文字輸入、模型生成、音訊封裝到第一個音訊 frame 傳送出去的整條 pipeline。
因此,如果下一階段要繼續優化,我會把重點放在:
最有意思的地方是,這次測試並沒有得到一個簡單的「買哪張卡」答案。
反而得到了一個更實用的結論:
AI 工作負載的效能,往往不是由顯卡規格表上的某一個數字決定,而是由「模型 × GPU 架構 × 顯存 × 推理框架 × 作業系統 × 服務架構」共同決定。
對想自己架設本地 AI 服務的人來說,真正值得測的,從來不只是 GPU-Z 上面的 TFLOPS 或顯存頻寬,而是**把整套系統跑起來之後,使用者究竟多久能聽到第一個字、同時能服務多少人,以及長時間運作是否穩定。
這也是這次三張卡實測最值得留下來的地方。
離線
相關討論主題
| 主題 | 回覆 | 點閱 | 最後發表 |
|---|---|---|---|
|
RTX 2080 Ti 22GB 文生圖模型測試 作者 Service
|
0 | 100 | 2026-09-24 23:31:45 作者 Service |
|
RTX 2080 Ti 22GB 魔改卡到貨:燒機驗收與實測心得 作者 Service
|
0 | 247 | 2026-09-18 16:09:23 作者 Service |
|
淘寶 2080 Ti「22GB 魔改卡」採購指南 作者 Service
|
0 | 243 | 2026-09-13 00:22:08 作者 Service |


