雙 2080 Ti 張量平行跑 27B:NVLink 到底差多少?
前兩篇我們用 Strata 在同一台機器上跑 125B 的 MoE 模型,這次換一個方向:用 vLLM 把 27B 的稠密模型「拆」到兩張 2080 Ti 上(張量平行,TP=2),接上我們自己的語音助理實際使用。
兩張卡之間沒有 NVLink,連 PCIe P2P 都不支援,原本擔心跑不起來或慢到不能用。結果不只跑得動,語音助理的首聲時間還接近雲端服務。這篇整理 NVFP4 與 FP8 的比較、MTP 該不該開,以及量測過程中意外抓到的一個 bug。後來 NVLink 橋接器到貨,我們也用同樣的設定補上了有/無 NVLink 的實測對照(◆07)。
■ 先講結論
---
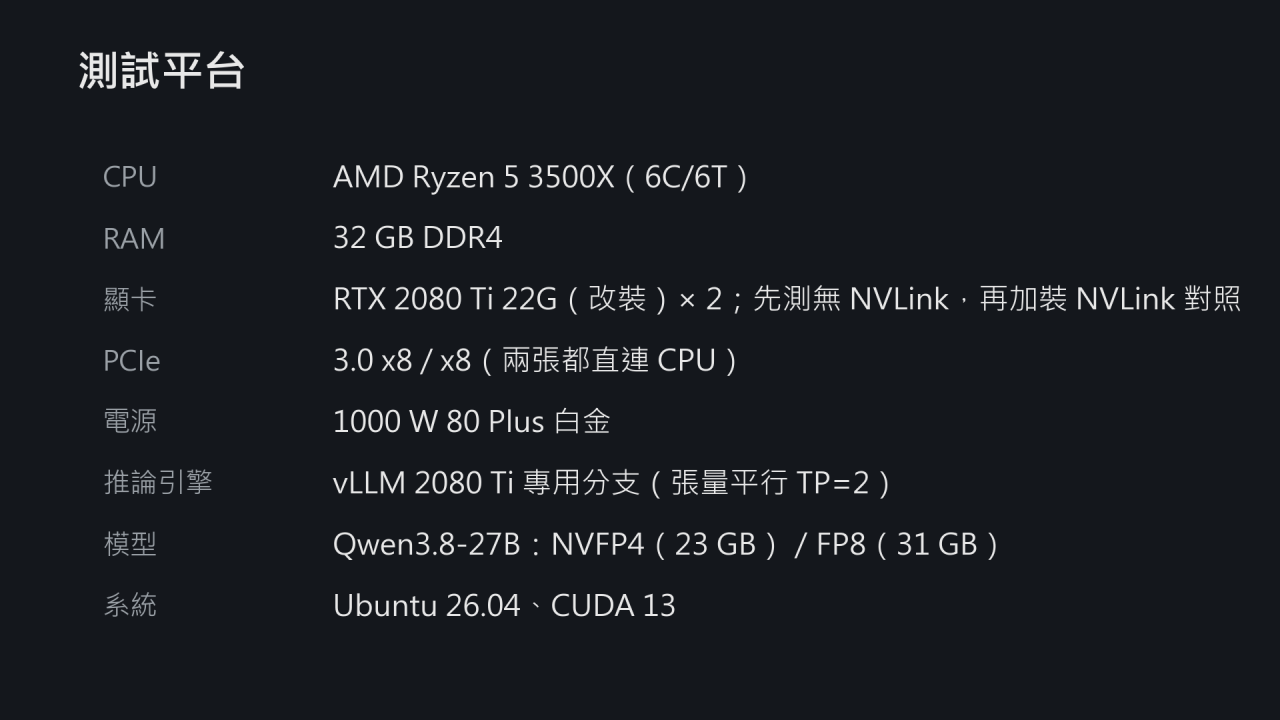
◆ 01 測試平台| 項目 | 規格 |
|---|
| 主機板 | MSI X470 GAMING PLUS MAX |
| CPU | AMD Ryzen 5 3500X(6C/6T) |
| RAM | 32 GB DDR4 |
| 顯卡 | RTX 2080 Ti 22G(改裝)× 2,◆02–◆06、◆08 為無 NVLink、PCIe P2P 不支援時的結果;◆07 加裝 NVLink 橋接器對照 |
| PCIe 實際連結 | 3.0 x8 / x8(兩張都直連 CPU) |
| 電源 | 1000 W 80 Plus 白金 |
| 系統 | Ubuntu 26.04、驅動 595、CUDA 13 |
| 推論引擎 | vLLM 的 2080 Ti 專用分支(weicj/vLLM-2080Ti-Definitive v0.2.2),TP=2 |
| 模型 | Qwen3.8-27B:NVFP4(unsloth,23.4 GB)/FP8(官方,30.9 GB) |
---
◆ 02 生成速度:NVFP4 vs FP8,MTP 開或關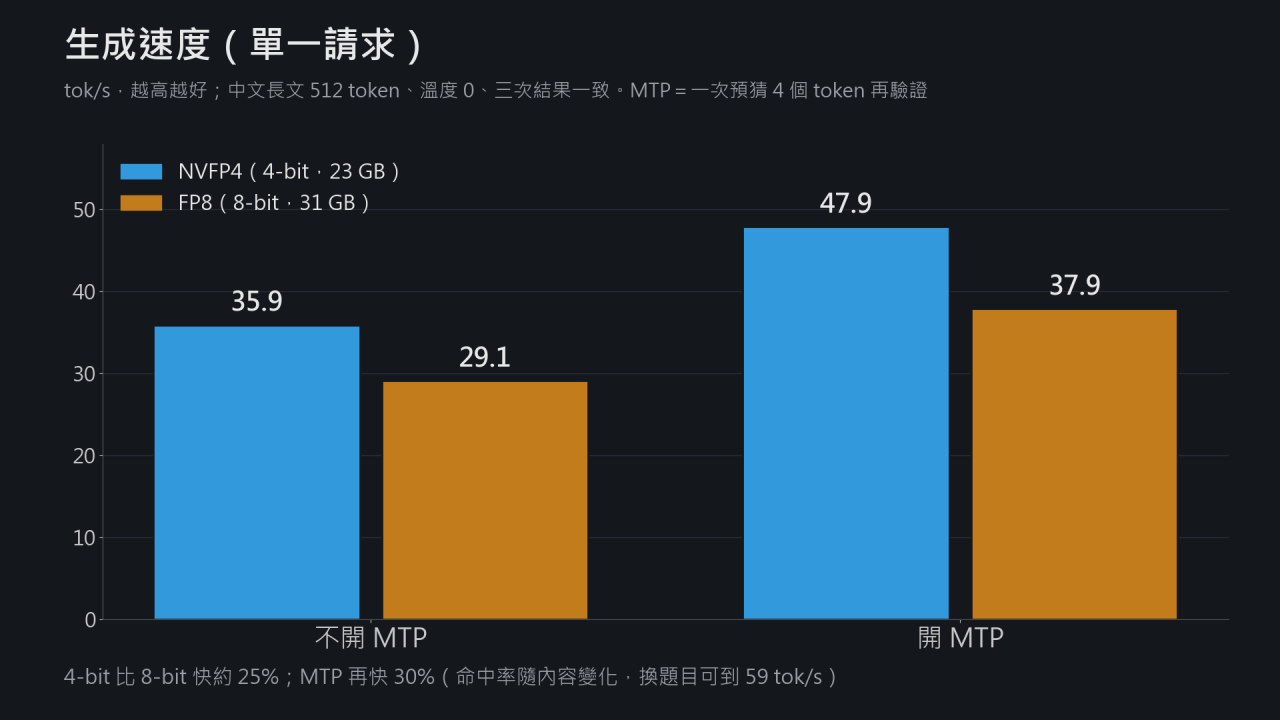
| 組合 | 生成速度 | 4 個請求同時(總速度) |
|---|
| NVFP4+MTP | 47.9 tok/s | 136 tok/s |
| NVFP4 | 35.9 tok/s | 82 tok/s |
| FP8+MTP | 37.9 tok/s | 108 tok/s |
| FP8 | 29.1 tok/s | 80 tok/s |
---
◆ 03 讀長提示詞:8-bit 反而比較快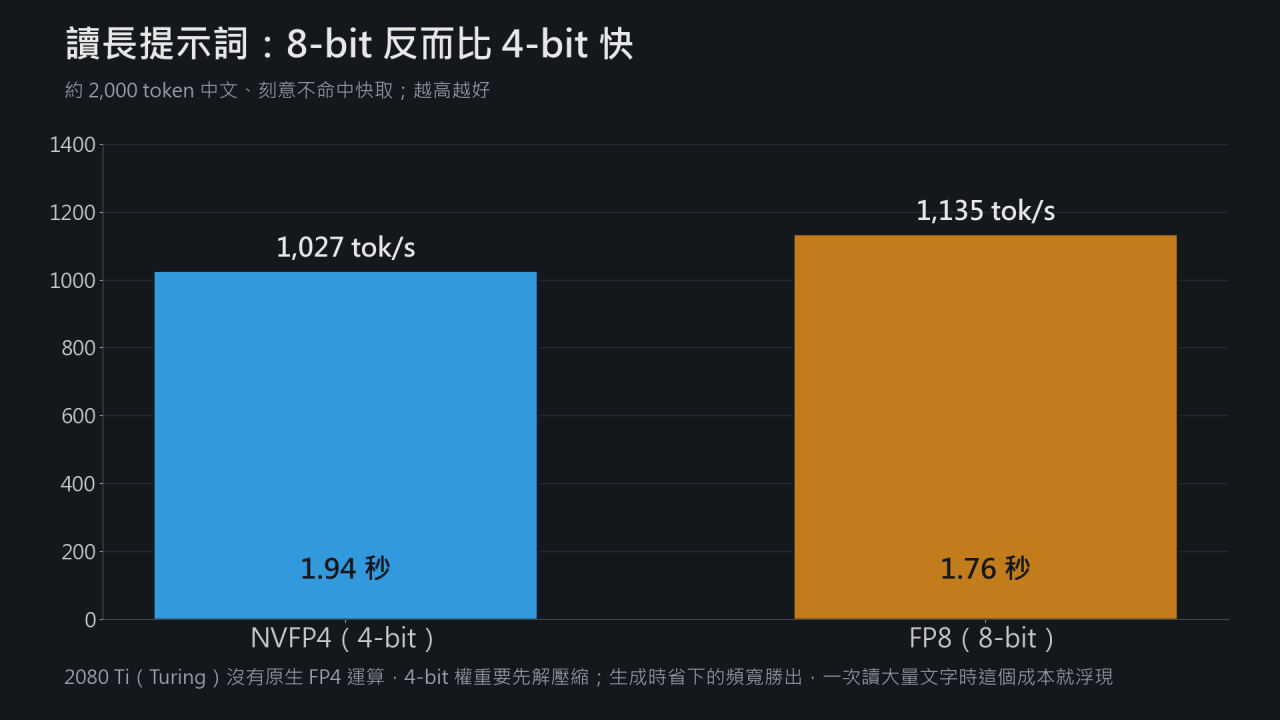
讀約 2,000 token 的中文提示詞(刻意不讓快取命中),FP8 要 1.76 秒、NVFP4 要 1.94 秒。
---
◆ 04 語音助理為什麼不開 MTP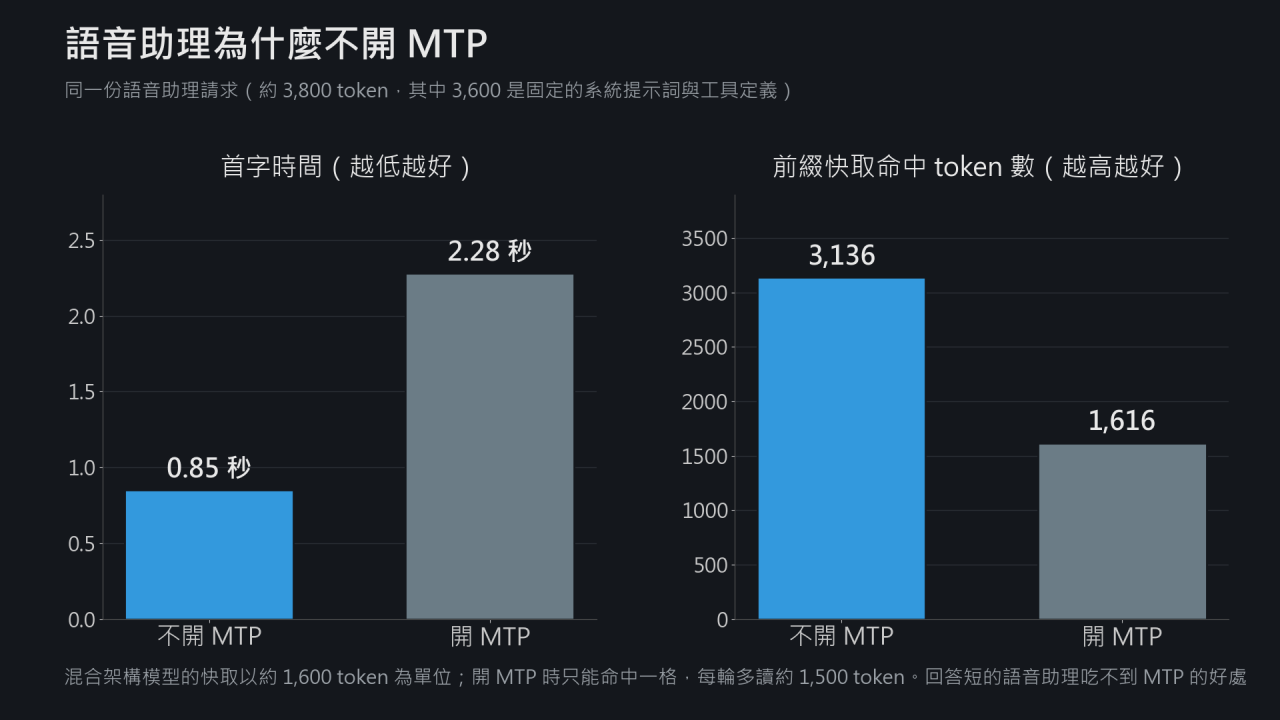
我們的語音助理每一輪要送約 3,800 token 給模型,其中約 3,600 是固定的系統提示詞和工具定義。這部分如果能命中前綴快取,每輪只需要讀新加的一兩百個字。
---
◆ 05 量測時抓到的 bug:多台同時使用慢了 36%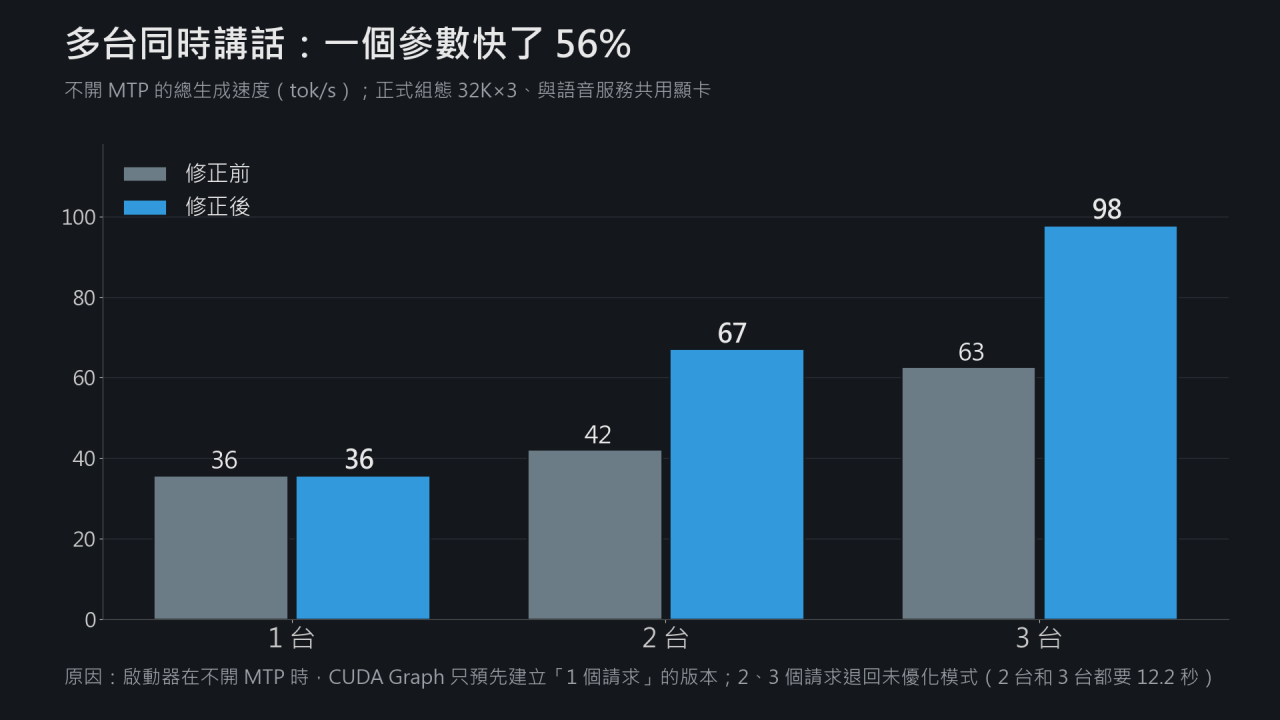
在正式設定(不開 MTP、32K × 3 路)下量多台同時使用時,發現一個奇怪的現象:
2 台同時生成和 3 台同時生成,花的時間一模一樣(都是 12.2 秒)。
---
◆ 06 工具呼叫的那一輪:改一行程式快了 3.7 秒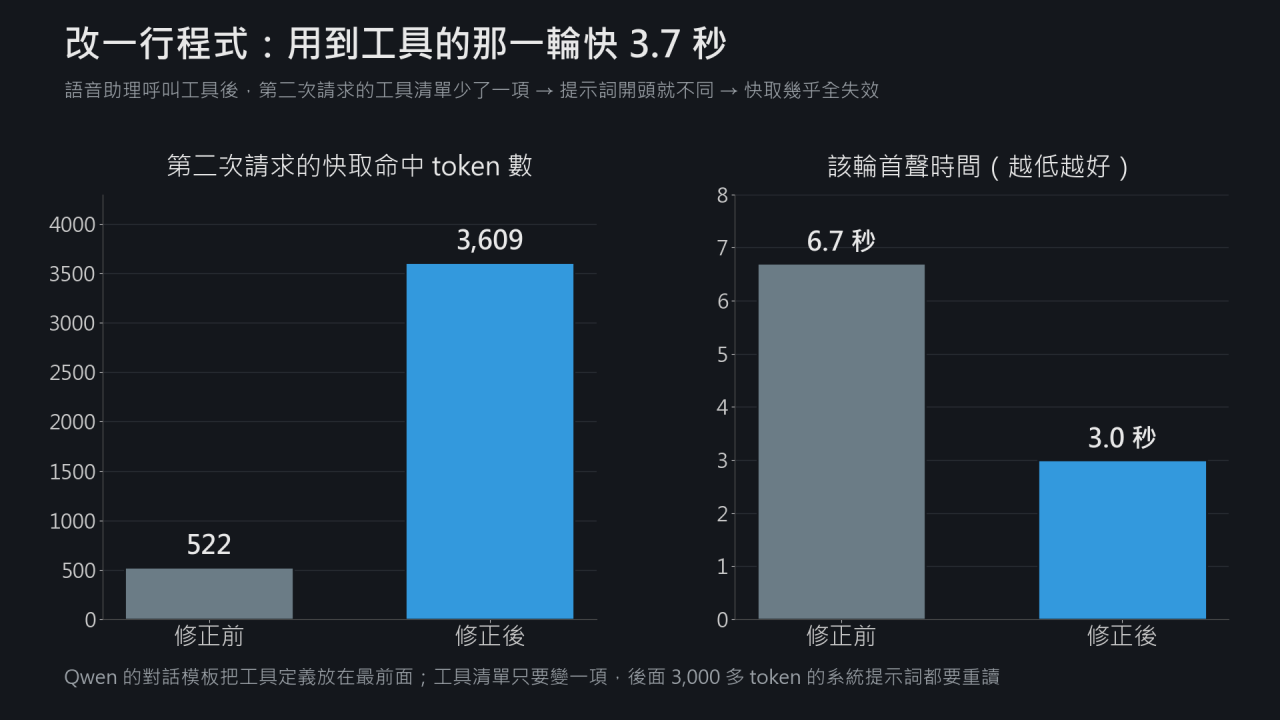
另一個前綴快取的坑,出在語音助理的伺服器程式。
---
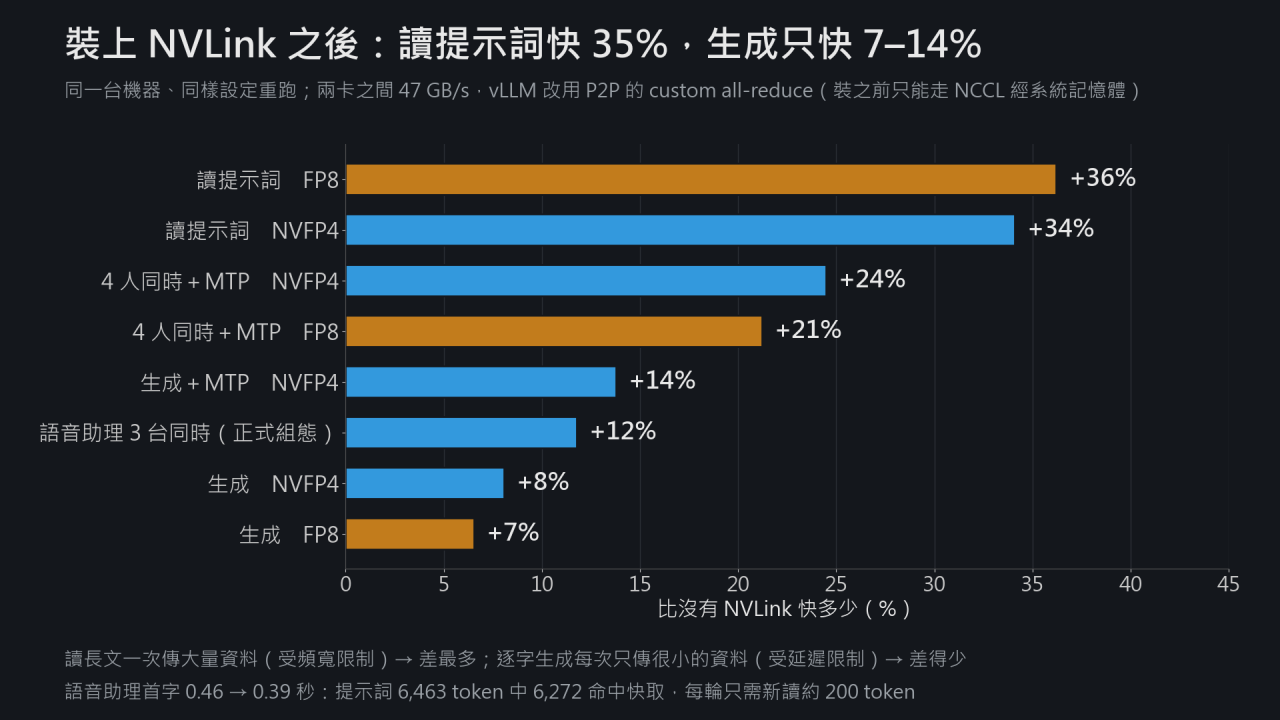
◆ 07 NVLink 實測:讀提示詞快 35%,生成只快 7–14%NVLink 橋接器(2080 Ti 用、3 槽寬)到貨後,我們用和前面完全相同的設定與題目,把全部基準重跑一次。
| 項目 | 無 NVLink | 有 NVLink | 差距 |
|---|
| 讀提示詞(NVFP4) | 1,027 tok/s(1.94 秒) | 1,377 tok/s(1.45 秒) | +34% |
| 讀提示詞(FP8) | 1,135 tok/s(1.76 秒) | 1,546 tok/s(1.29 秒) | +36% |
| 生成(NVFP4) | 35.9 tok/s | 38.8 tok/s | +8% |
| 生成(FP8) | 29.1 tok/s | 31.0 tok/s | +7% |
| 生成+MTP(NVFP4) | 47.9 tok/s | 54.5 tok/s | +14% |
| 4 路同時+MTP(NVFP4) | 136 tok/s | 170 tok/s | +24% |
| 語音助理正式組態,3 台同時 | 98 tok/s | 109 tok/s | +12% |
| 語音助理首字時間 | 0.46 秒 | 0.39 秒 | 快 70 毫秒 |
| 生成時兩卡功耗 | 約 500 W | 約 505 W | 幾乎不變 |
值不值得買?以語音助理、一般聊天這種「提示詞大多命中快取、回答短」的用法,沒有 NVLink 也完全夠用;如果常丟長文件給模型讀、或多人同時使用,NVLink 帶來的 20–35% 就很有感。要注意橋接器有槽距規格(我們用的是 3 槽寬),買之前先量兩張卡的間距。
---
◆ 08 功耗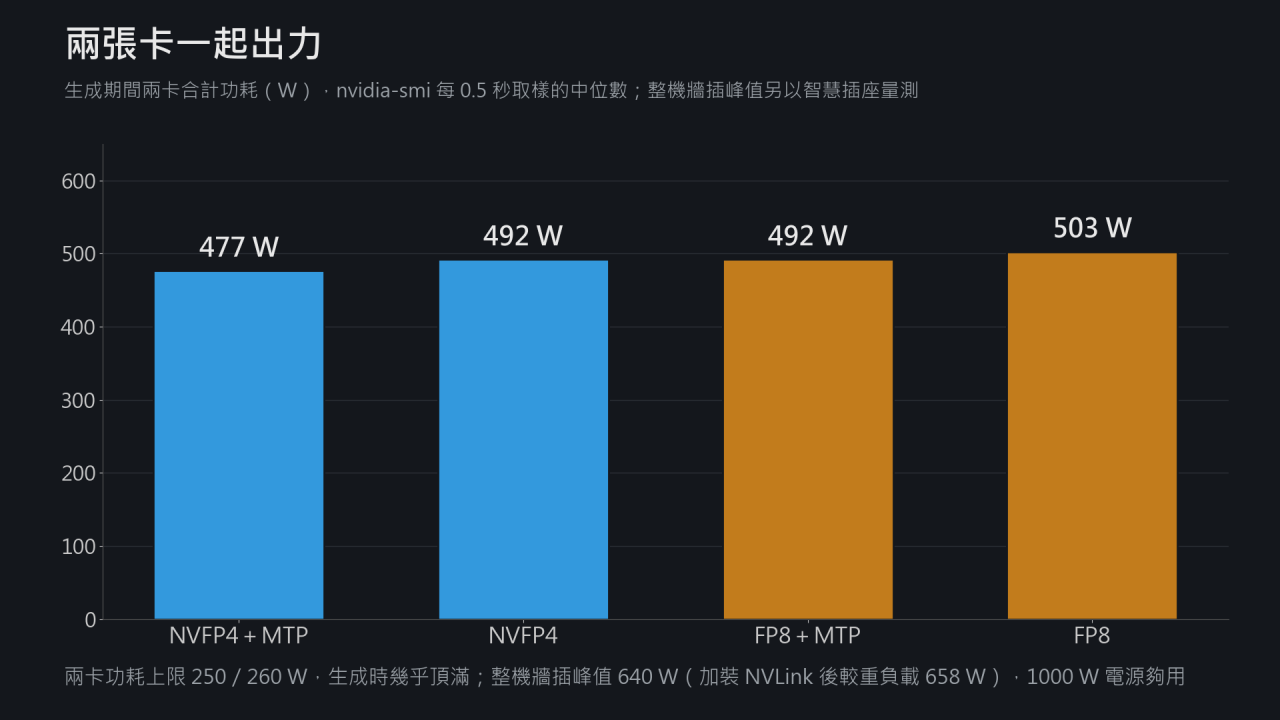
生成期間兩張卡合計約 480–500 W,兩卡的功耗上限分別是 250/260 W,幾乎頂滿。整機牆插峰值(智慧插座量測):前面的基準測試約 640 W;加裝 NVLink 後那一輪(含 16 人同時、開 MTP 等較重的負載)最高 658 W。兩卡生成時的功耗在裝 NVLink 前後幾乎一樣,多出來的十幾瓦主要來自負載不同。1000 W 白金電源還有不少餘裕。
---
◆ 09 架設時踩到的坑---
◆ 10 心得總結和前兩篇的 125B MoE 相比,27B 稠密模型在同一台機器上的定位很不一樣:125B 生成快(約 70 tok/s)但讀長提示詞慢、RAM 吃緊;27B 用張量平行拆到兩張卡,提示詞讀取快、配合前綴快取,
語音助理的首聲約 2.5–3 秒,接近雲端服務。
這次最大的收穫其實不是跑分,而是
量測本身找到了問題:一個讓多台同時使用慢 36% 的 bug、一行讓快取失效的程式。沒有實際量測,這兩個問題可能一直都不會被發現。
至於 NVLink:它確實讓讀長提示詞快了三成多,但對「提示詞大多命中快取、回答很短」的語音助理幾乎沒有差別。
要不要買,先看自己的用法卡在頻寬還是延遲。
◆ 補充 網路上「開 MTP 單人 120 tok/s」是怎麼來的?文章寫完後,我們看到網路上一支同樣是「雙 2080 Ti+NVLink」的實測影片:int4 模型開 MTP,單人生成 120 tok/s、FP8 也有 94.5 tok/s,是我們實測的兩倍。我們用同一台機器追查了一輪,原因有兩個。
1. 4-bit 格式不同:INT4 在 2080 Ti 上確實比 NVFP4 快對方用的是 GPTQ 類的 int4(W4A16),我們原本用 NVFP4。我們下載了這個分支官方支援的
RedHatAI/Qwen3.8-27B-INT4 來比:
2. 開 MTP 的 120 tok/s,很可能是「合成測試」的數字這個分支內建一套參考基準,條件正好是「4K 輸入/128 輸出」:
輸入是 4,096 個重複的英文單字 " the",輸出用參數強制限定只能是 " the"。程式說明自己也寫著「for synthetic throughput, not correctness」。這種輸出 MTP 每次都猜得中,速度自然被放大好幾倍。
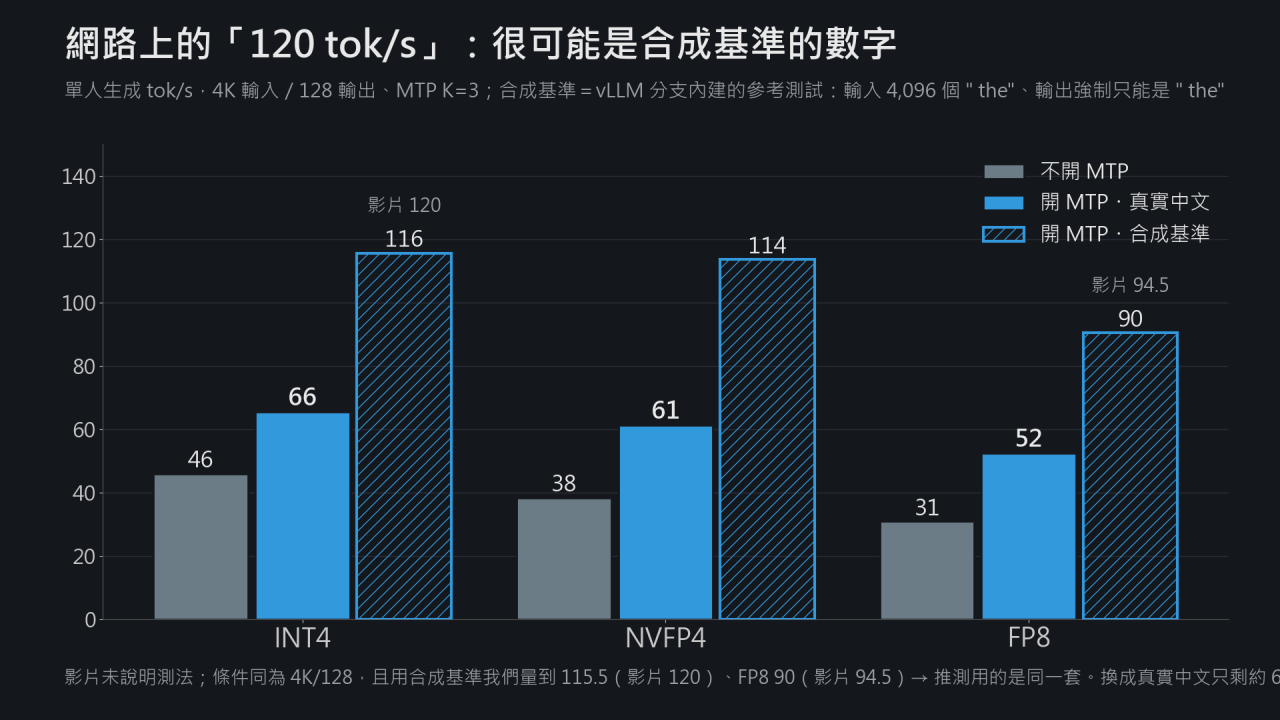
| 開 MTP(K=3)單人 | 合成基準(只輸出 " the") | 真實中文內容 | 網路影片 |
|---|
| INT4 | 115.5 tok/s | 65.5 tok/s | 120.0 tok/s |
| NVFP4 | 113.5 tok/s | 61.2 tok/s | — |
| FP8 | 90.4 tok/s | 52.4 tok/s | 94.5 tok/s |
其他對得上的地方那我們的語音助理要不要換 INT4?我們決定不換。速度確實比較快,但用我們語音助理的正式提示詞做工具呼叫測驗(關思考,每題 20 次),INT4 的安全關鍵項合規率 73.8%,NVFP4 是 86.2%;最重要的「確認跌倒時要呼叫通報工具」,INT4 只有 11/20,NVFP4 是 18/20。
同樣是 4-bit,不同的量化方式會讓模型行為不一樣,換之前一定要用自己的題目測過。
心得:看到別人的跑分比自己快很多時,先確認是不是同一種測法;尤其 MTP、推測解碼這類「靠猜」的加速,數字非常吃內容。
---
■ 參考連結■ 同系列文章(圖表與原始數據都是我們自行量測整理,歡迎討論或指正。)