#1 昨天 21:06:41

Qwen3.8-27B 本地測試計畫
前言
本文整理 RTX 2080 Ti 22GB(改裝版)本地運行 Qwen3.8-27B 的測試計畫,包含環境配置、效能優化與進階加速(DFlash2 / 推測解碼)說明。文中亦補充筆者查證的模型背景與部署建議,供有興趣在消費級硬體上運行 27B 級模型的讀者參考。
聲明:本文撰寫時,筆者訂購的 2080 Ti 22GB 魔改卡仍在運送途中,所有效能數字皆為理論估算與既有社群回報,尚未經筆者本機實測。待到貨完成壓力測試後,將另行補充實測結果。
---
一、模型與硬體摘要
Qwen3.8-27B(官方資料,2026-08-14 開源)
測試硬體:RTX 2080 Ti 22GB(改裝版)
二、基準數據參考(官方與第三方測評)
| 指標 | Qwen3.8-27B | 前代 Qwen3.6-27B |
| DeepSWE 1.1 | 42.2 | 13.3 |
| Terminal Bench 2.1 | 73.0 | 63.4 |
三、環境配置與啟動參數
建議使用 llama-server 建立獨立推論服務,並啟用 Flash Attention 與 KV Cache 4-bit 量化:
llama-server \
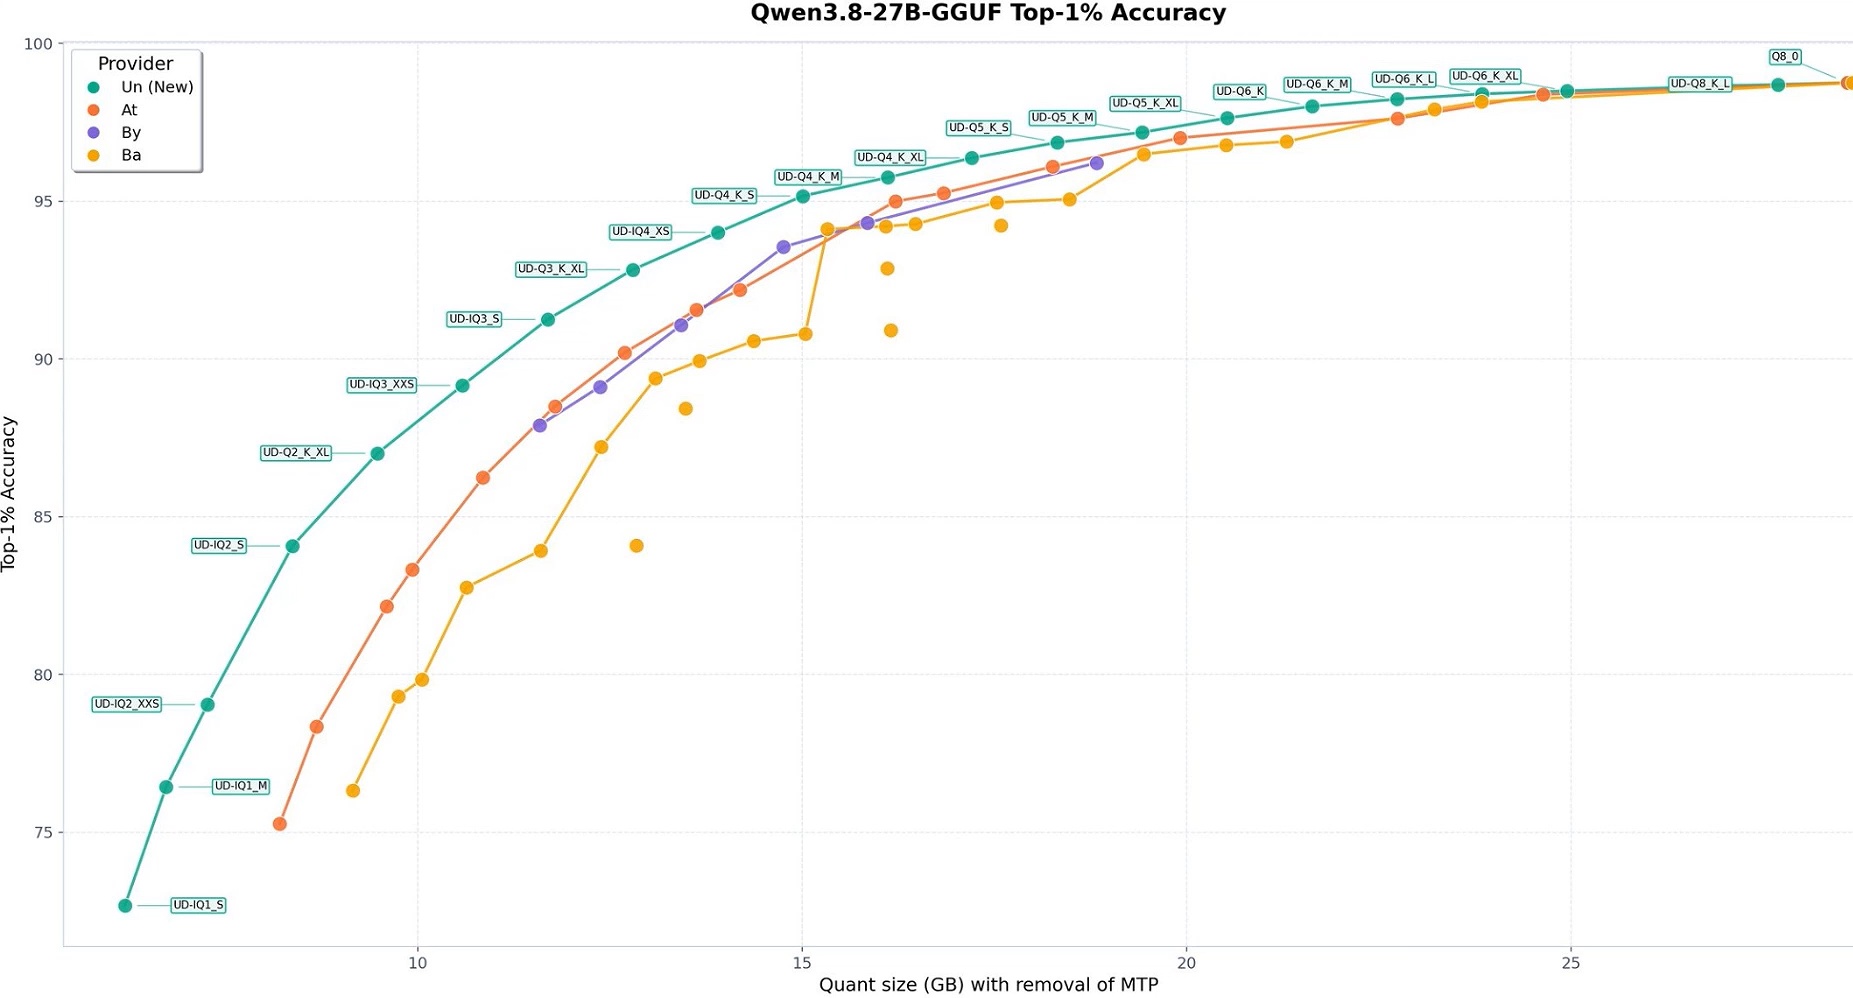
  -m qwen3.8-27b-iq4_xs.gguf \
  --n-gpu-layers 99 \
  --ctx-size 32768 \
  --cache-type-k q4_0 \
  --cache-type-v q4_0 \
  --flash-attn
四、效能優化設定
預設配置下估算吐字速度為 12~18+ t/s;極限調優有機會推升至 22~28+ t/s。四個優化維度:
1. 鎖定 Pinned Memory(--mlock)
預設 llama.cpp 以 mmap 讀取模型,可能觸發分頁調度開銷。加上 --mlock 可將模型鎖定於實體記憶體,避免被換出至 Swap,維持 GPU 顯存補給穩定。
2. 精準搭配 FlashAttention 與 CUDA Kernels
Turing 架構(CC 7.5)處理非對稱量化開銷較大,指定 --flash-attn;KV Cache 量化建議選用原生 CUDA 加速格式(q4_0 / q8_0 / f16),避免非原生格式拖慢運算。
3. 開啟推測解碼(Speculative Decoding / MTP)
Qwen3.8 原生支援 Multi-Token Prediction(MTP)。掛載小 Draft 模型或啟用 --spec-draft-n-max 2,由小模型預測 2~3 個 token、主模型一次驗證,可將生成速度提升 25%~40%。
4. 針對任務調整 Context 與 Thinking
將 Context 自極限 64K 下調至實用的 16K~32K,能釋放 3~4GB VRAM 給 CUDA 動態批次;程式碼等專一任務可收斂思考預算(Reasoning Budget),改善長文本「前快後慢」現象。
極限效能啟動範例(挑戰 20+ t/s)
llama-server \
  -m qwen3.8-27b-iq4_xs.gguf \
  --n-gpu-layers 99 \
  --ctx-size 32768 \
  --cache-type-k q4_0 \
  --cache-type-v q4_0 \
  --flash-attn \
  --mlock \
  --spec-draft-n-max 2
五、進階加速:DFlash2 / 推測解碼
核心邏輯:以極低計算開銷預測 token,減少主模型讀取顯存權重的次數。
速度預估對比:
| 模式/設定 | 預估速度 | 說明 |
|---|---|---|
| 原生 llama.cpp / MLX(無推測) | 12 ~ 18 t/s | 標準解碼,每次輸出 1 token |
| 掛載 DFlash2 / MTP(2 Draft) | 25 ~ 38+ t/s | 猜中率約 60%~75%,速度翻倍 |
| 極致順暢(High Acceptance) | 40+ t/s | 結構化程式碼等高猜中率情境逼近極限 |
六、筆者補充建議(上線前)
七、總結
在 RTX 2080 Ti 22GB 上啟用推測解碼,有機會在保有 100% 無損精確度的前提下,享受 30+ tokens/sec 的本機推論速度。對想以有限預算踏入本地 LLM 的讀者而言,此組合具備相當高的成本效益。
本文為整理與規劃性質;實際硬體表現可能因賣家批次與韌體而異,歡迎讀者補充實測數據。

離線


