#1 今天 11:36:31

算力解鎖了,AI 卻沒變快?看懂 gpu-unlock 的真正用途
算力解鎖了,AI 卻沒變快?看懂 gpu-unlock 的真正用途
看到顯示卡解鎖、特定運算速率翻倍,很容易聯想到「本機 AI 也能快兩倍」。但實際使用時,讀取長提示詞可能變快,回答逐字跳出的速度卻幾乎不變。問題通常在於:我們比較的根本不是同一種速度。
這篇由我們整理 Zagitta/gpu-unlock 的機制、社群數據與使用邊界,幫大家判斷它是否對自己的工作有幫助。
資料範圍:沿用影片的 2026-10-26 文件版本(提交 990a14e)。效能數據皆為社群回報,我們未進行 GPU 解鎖或本機效能實測。
一、先分清楚:AI 在「讀」,還是在「寫」?
以「交給模型一篇長文章,請它摘要」為例,等待可以拆成兩段:
Prefill(提示詞處理):先處理你輸入的內容,這個階段可能包含大量矩陣運算。
Decode(回答生成):接著逐一產生 token;token 是模型處理的文字單位,不一定等於一個中文字。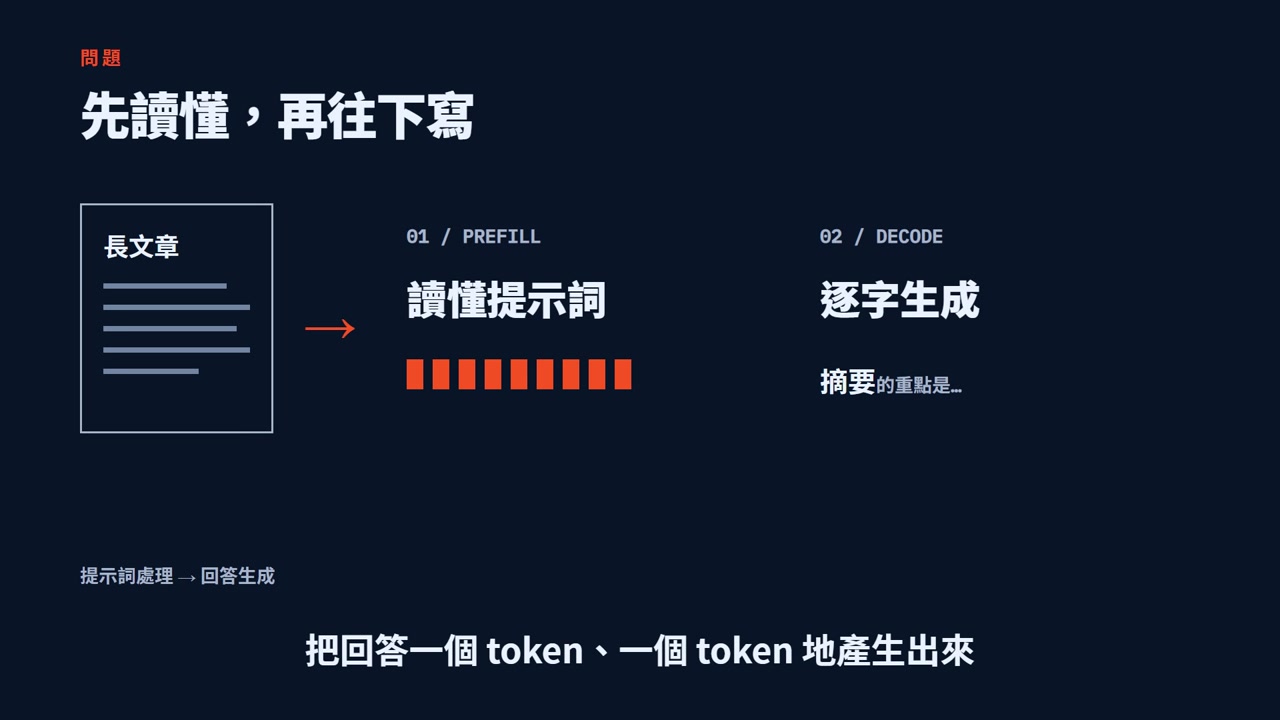
圖 1:提示詞處理與逐字生成是不同階段,應分開觀察。
如果原本大部分時間都花在「寫」,只加快「讀」的階段,整體感受就可能有限。例如讀取 10 秒、生成 90 秒,假設讀取速度提高兩倍,總時間也只是從 100 秒降為 95 秒。這是說明原理的假設例子,不是專案實測。
二、gpu-unlock 到底解鎖什麼?
依指定版本 README,這是一個 Linux 核心模組,針對部分 Ampere 晶片,提高特定 FP16/BF16 乘加、以 FP32 累加時的指令發射速率。
特定指令的速率翻倍,不能直接換算成整個模型、所有精度或所有 AI 工作都快兩倍。
它在 NVIDIA 驅動接手之前完成設定與功能層級重設,再由原版驅動接手。這個儲存庫的安裝方式以 Linux 為對象,Windows/UEFI 的其他移植需要另外確認。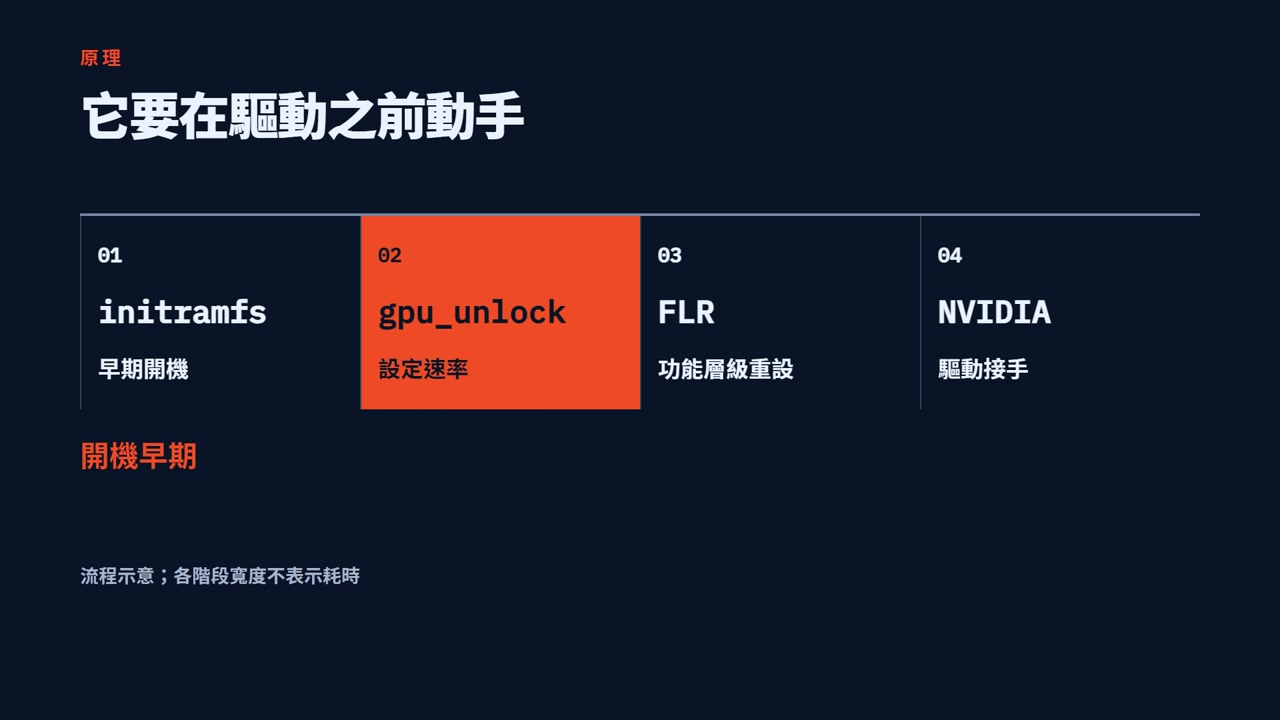
圖 2:開機流程示意;圖中各階段寬度不代表耗時。
三、矩陣測試確實有提升,但要一起看測試條件
社群回報 #1 使用 RTX 3090 Ti、450 W 功耗上限、8192³ 稠密矩陣乘法,採 FP32 累加,取五次測量中位數:
| 格式 | 解鎖前(TFLOPS) | 解鎖後(TFLOPS) | 約提升 |
|---|---|---|---|
| FP16 | 87.46 | 118.39 | 35% |
| BF16 | 87.50 | 157.41 | 80% |
| TF32 | 42.58 | 82.61 | 94% |
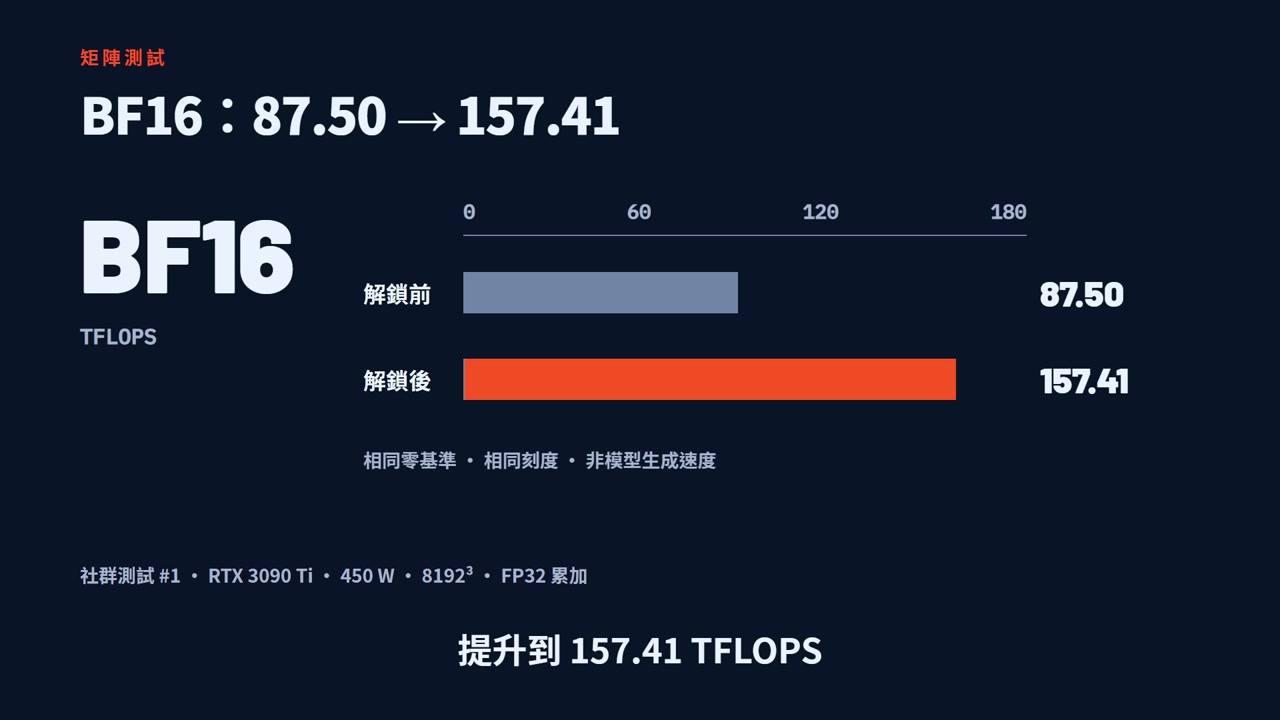
圖 3:BF16 矩陣吞吐量比較;兩條長條採相同零基準與刻度。
TFLOPS 描述這項運算測試的吞吐量,不能當成模型每秒生成 token 的速度。原回報使用修改過的驅動與自訂 pre-udev initramfs hook,也不能保證目前套件在其他環境重現同一組數字。
來源:RTX 3090 Ti 社群測試 #1
四、真實 LLM 工作:提示詞長度也會影響結果
指定版本 README 彙整的 LLM Prefill 回報約提升 14%~36%,這是不同環境的回報範圍,並非保證值。
以 #9 的 RTX 3090/Strata 回報為例:
| 提示詞長度 | 解鎖前(tok/s) | 解鎖後(tok/s) | 約提升 |
|---|---|---|---|
| 4K | 1,220 | 1,225 | 0.4% |
| 16K | 2,594 | 3,009 | 16% |
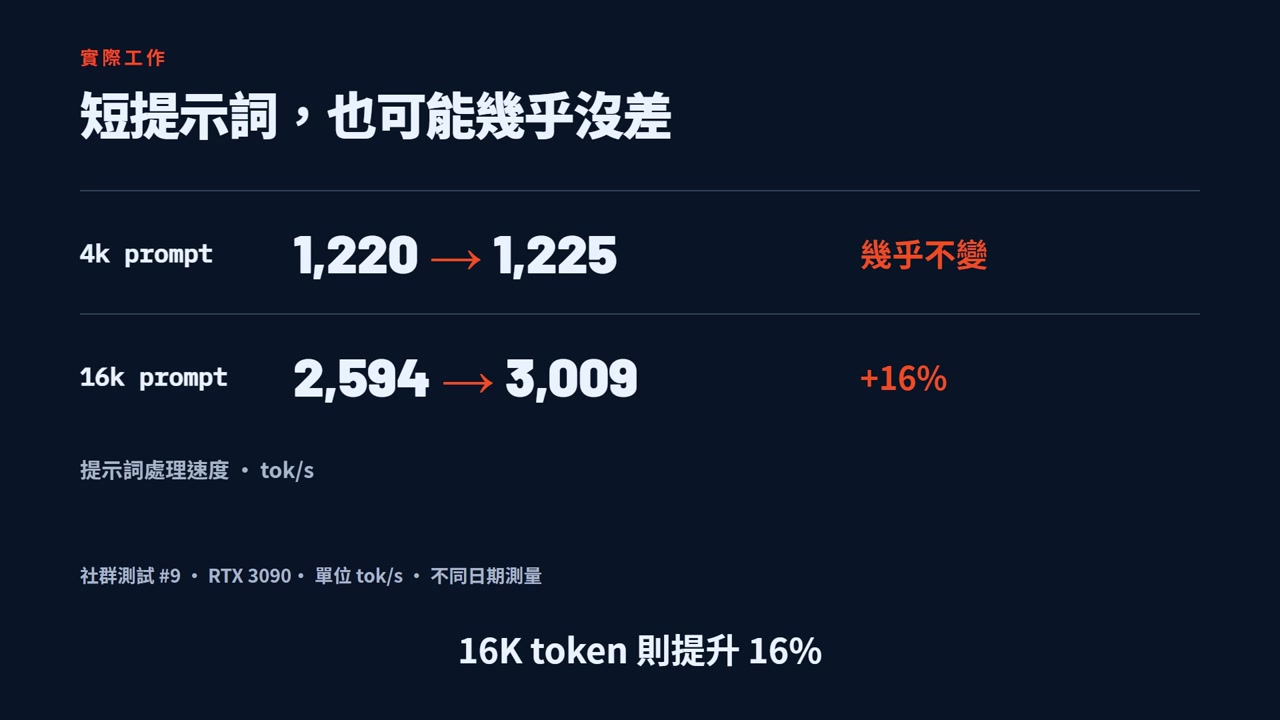
圖 4:同一份回報中,短提示詞幾乎不變,長提示詞的提升較明顯。
這份前後數據來自不同日期,應視為單一使用者回報,不能當成嚴格控制其他變因的實驗。它提醒我們:比較模型名稱還不夠,輸入長度與測量方式也要一起記錄。
來源:相容性與 Prefill 回報 #9
五、為什麼逐字生成可能沒什麼感覺?
當工作主要受顯存資料搬移速度限制,就算提高運算端的能力,資料仍然來不及送達。可以把它想成加快廚師炒菜,但出菜速度卡在食材運送:廚師更快,不表示餐點就會等比例加速。
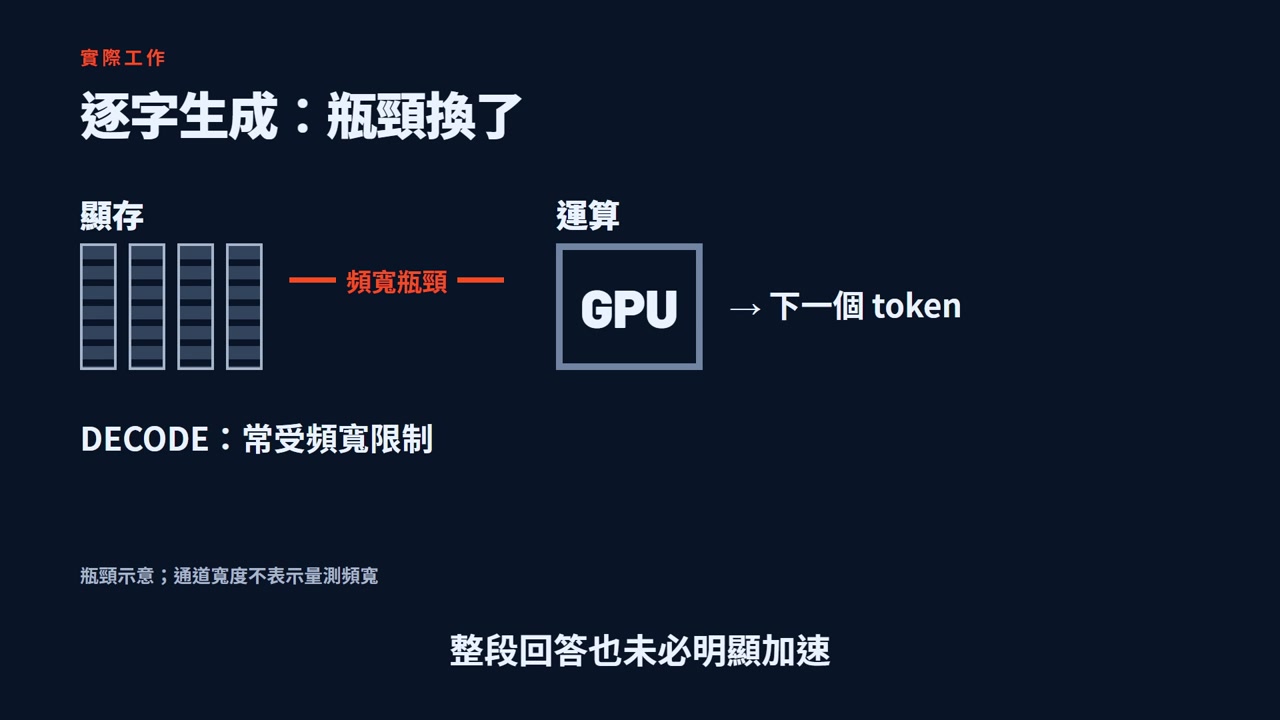
圖 5:頻寬瓶頸示意;通道寬度不是量測值。
指定版本 README 將 LLM Decode 與 INT8 列為大致不變的工作。這也意味著,BF16 矩陣測試的提升,不能直接套用到你正在使用的量化模型。
六、解鎖流程成功,也不代表效能一定增加
#28 有一張 GA102-250/RTX 3080 Ti 20 GB OEM 的回報:解鎖流程完成,BF16 吞吐量仍維持半速。這是特定 OEM 卡的案例,不能直接外推到零售版 RTX 3080 Ti。
來源:解鎖完成但 BF16 仍半速的回報 #28
因此,判斷是否適用時,要查具體晶片、裝置 ID、卡型與對應回報,不能只看「RTX 30 系列」這個名稱。
七、想驗證自己的卡,建議怎麼比較?
先確認對應版本的相容性與還原方式,再依發行版文件處理模組、早期開機映像與目標卡參數。它需要在驅動接手前生效,並非進入桌面後載入模組就能完成。
實際比較時,我們建議保留以下紀錄:
1. 顯示卡完整型號、晶片、裝置 ID、驅動與核心版本。
2. 相同模型與版本、推論引擎、精度、量化設定、批次大小。
3. 相同提示詞、輸入長度與輸出長度;避免快取命中狀態不同。
4. 相同功耗設定與暖機方式,重複測量並記錄中位數。
5. Prefill、Decode 與端到端時間分開記錄。
6. 同時確認輸出正確性、錯誤日誌、溫度與穩定性。
核心日誌只能幫你確認流程與狀態;對工作是否有幫助,仍要靠同條件的應用測試回答。
我們的看法
如果你在 Linux 使用相容卡,主要跑矩陣密集工作,gpu-unlock 有研究與驗證價值。如果最在意的是聊天回答逐字出現的速度,先量出時間花在哪裡,會比只看最高加速百分比更有用。
看清楚瓶頸,再看加速。
參考文件:本文採用的 README 固定版本
專案網址:https://github.com/Zagitta/gpu-unlock
離線


